Cloud Computing

PlAwAnSaI

Administrator
  • ค่าบริการ EC2:
    • Standard Reserved Instance มีส่วนลดให้ เมื่อระบุกลุ่มประเภท Instance และขนาด, สิทธิ์การใช้งานอย่างใดอย่างหนึ่งใน Region 1 แห่ง
      โดยจำนวน EC2 Instance ในการเรียกใช้ระบบปฏิบัติการครอบคลุมอยู่ในระยะเวลา 1 ปี หรือ 3 ปี โดย 3 ปีมีส่วนลดให้มากกว่า
    • EC2 Instance Savings Plans ลดค่าใช้จ่าย EC2 Instance ให้ เมื่อมีข้อผูกมัดในการใช้จ่ายเป็นรายชั่วโมงกับกลุ่มประเภท Instance และ Region เป็นระยะเวลา 1 ปี หรือ 3 ปี
      .
  • Elastic Load Balancing: เป็นบริการของ AWS ที่กระจายการรับส่งข้อมูลของ App ขาเข้าโดยอัตโนมัติในทรัพยากรต่างๆ เช่น Amazon EC2 Instance ซึ่งช่วยตรวจสอบให้แน่ใจว่าไม่มีทรัพยากรแม้แต่รายการ/Instance เดียวจะมีการใช้งานมากเกินไป

  • Amazon Simple Notification Service (Amazon SNS) เป็นบริการเผยแพร่/สมัครรับข้อมูล ผู้เผยแพร่จะใช้ Amazon SNS Topic เพื่อเผยแพร่ข้อความไปยังผู้สมัครรับข้อมูล ตัวอย่างง่ายๆ > สมมติมี App ขายของ Online
    เวลามีคำสั่งซื้อใหม่ → ระบบส่งข้อความไปที่ SNS Topic: "NewOrderTopic"
    Subscribers อาจเป็น
    • Lambda → ไว้ประมวลผลคำสั่งซื้อ
    • Email → ส่งแจ้ง Team ขาย
    • SMS → แจ้งลูกค้า
      สรุปคือ ส่งครั้งเดียว แต่กระจายถึงหลายปลายทางอัตโนมัติ
      .
  • Amazon SQS เป็นบริการจัด Queue ข้อความ ทำให้นักพัฒนา App สามารถส่ง จัดเก็บ และรับข้อความระหว่างองค์ประกอบ Software ต่างๆ ได้ทุกขนาด Volume โดยไม่มีการสูญเสียข้อความหรือจำเป็นต้องใช้บริการอื่นๆ โดย App จะส่งข้อความเข้าไปใน Queue ผู้ใช้หรือบริการจะเรียกค้นข้อความจาก Queue ประมวลผลข้อความ แล้วลบข้อความออกจาก Queue

  • AWS Lambda เป็นบริการที่เรียกใช้ Code ได้โดยไม่จำเป็นต้องจัดสรรหรือจัดการ Server
    ในขณะที่ใช้งานธุรกิจจะจ่ายตามเวลาการประมวลผลที่ใช้เท่านั้น โดยจะมีการเก็บค่าบริการเฉพาะเมื่อ Code ของ App ทำงานอยู่เท่านั้น โดยสามารถเรียกใช้ Code สำหรับ App เกือบทุกประเภทหรือบริการ Backend ได้โดยไม่ต้องมีการดูแลจัดการใดๆ

  • การติดตั้ง (Deploy), ใช้งาน (Run) และ จัดการ (Manage) App ที่ใช้ Container บน AWS บริการที่เหมาะคือ:
    • Amazon Elastic Container Service (ECS) → จัดการคอนเทนเนอร์ง่าย ใช้งานกับ AWS ได้ทันที เหมาะกับคนที่ไม่อยากดูแล Kubernetes เอง หรือ
    • Amazon Elastic Kubernetes Service (EKS) → ใช้ Kubernetes แบบ Managed Service เหมาะถ้าต้องการมาตรฐาน Kubernetes และความยืดหยุ่นสูง
3. โครงสร้างพื้นฐาน:
  • Region ประกอบด้วย Availability Zone (AZ) อย่างน้อย 3 แห่ง
    ตัวอย่างเช่น Region ของไทย คือ ap-southeast-7 ซึ่งจะประกอบด้วย AZ 3 แห่ง ได้แก่ ap-southeast-7a, ap-southeast-7b และ ap-southeast-7c

  • เมื่อเลือก Region ควรพิจารณา:
    • การปฏิบัติตามข้อกำหนดด้านการกำกับดูแลข้อมูลและข้อกำหนดทางกฎหมาย
    • ระยะใกล้เคียงกับลูกค้า
    • ค่าบริการ และ
    • บริการที่มีอยู่ใน Region
      .
  • AZ คือ ศูนย์ข้อมูลแห่งเดียวหรือกลุ่มศูนย์ข้อมูลภายใน Region ที่แยกกันโดยสมบูรณ์ของโครงสร้างพื้นฐานทั่วโลกของ AWS โดยแต่ละแห่งจะตั้งอยู่ห่างจากกันหลายสิบ Kilometer

  • Amazon CloudFront เป็นบริการส่งมอบเนื้อหา โดยบริการนี้ใช้เครือข่าย Edge Location ในการ Cache เนื้อหาและส่งมอบเนื้อหาให้กับลูกค้าทั่วทุกมุมโลก เมื่อเนื้อหาได้รับการ Cache ก็จะถูกจัดเก็บไว้เป็นสำเนาในเครื่อง เนื้อหานี้อาจเป็น File Video, รูปภาพ, หน้า Web, และอื่นๆ

  • ด้วย AWS Outposts สามารถขยายโครงสร้างพื้นฐานและบริการของ AWS ไปยังตำแหน่งที่ตั้งต่างๆ ซึ่งรวมถึงศูนย์ข้อมูลในองค์กร
4. ระบบเครือข่าย:
  • Subnet คือส่วนของ VPC ที่สามารถจัดกลุ่มทรัพยากรตามความต้องการด้านความปลอดภัยหรือการดำเนินการได้ อาจเป็นแบบสาธารณะหรือแบบส่วนตัวก็ได้
    • Subnet สาธารณะมีทรัพยากรที่ต้องสามารถเข้าถึงได้จากสาธารณะ/Internet เช่น Website ของร้านค้า Online
    • Subnet ส่วนตัวมีทรัพยากรที่ควรสามารถเข้าถึงได้ผ่านทางเครือข่ายส่วนตัวเท่านั้น เช่น ฐานข้อมูลที่มีข้อมูลส่วนบุคคลและประวัติการสั่งซื้อของลูกค้า
    .
  • AWS Direct Connect สามารถนำไปใช้เพื่อสร้างการเชื่อมต่อแบบ Dedicated ส่วนตัวระหว่างศูนย์ข้อมูลของบริษัทกับ AWS ได้

  • รายการควบคุมสิทธิ์เข้าถึง (ACL) สำหรับเครือข่ายดำเนินการกรอง Packet แบบ Stateless โดยจะไม่จดจำข้อมูลใดๆ และจะตรวจสอบ Packet ที่ข้ามขอบเขตของ Subnet ทุกครั้งทั้งขาเข้าและขาออก
    บัญชี AWS แต่ละบัญชีจะมี ACL สำหรับเครือข่ายที่เป็นค่าเริ่มต้น เมื่อกำหนดค่า VPC สามารถใช้ ACL สำหรับเครือข่ายที่เป็นค่าเริ่มต้นของบัญชี หรือสร้าง ACL สำหรับเครือข่ายแบบกำหนดเองก็ได้
    ตามค่าเริ่มต้นแล้ว ACL สำหรับเครือข่ายที่เป็นค่าเริ่มต้นของบัญชีจะอนุญาตให้มีการรับส่งข้อมูลขาเข้าและขาออกทั้งหมด แต่สามารถปรับเปลี่ยนการตั้งค่านี้ได้โดยเพิ่มกฎของตนเอง
    ส่วน ACL สำหรับเครือข่ายแบบกำหนดเองนั้น การรับส่งข้อมูลขาเข้าและขาออกทั้งหมดจะถูกปฏิเสธจนกว่าจะเพิ่มกฎเพื่อระบุว่าการรับส่งข้อมูลใดที่ควรได้รับอนุญาต นอกจากนี้ ACL สำหรับเครือข่ายทั้งหมดยังมีกฎการปฏิเสธโดย Default อีกด้วย กฎนี้มีไว้เพื่อให้แน่ใจว่าหาก Packet ไม่ตรงกับกฎใดในรายการ Packet ดังกล่าวก็จะถูกปฏิเสธ
    เหมือน 📜 รายชื่อแขกในงานสัมนา → ACL ที่อนุญาตให้เฉพาะชื่อใน List เข้าไปในงานได้

  • Security Group (SG) คือ Firewall เสมือนที่ควบคุมการรับส่งข้อมูลขาเข้าและขาออกสำหรับ Amazon EC2 Instance
    ตามค่าเริ่มต้นแล้ว SG จะปฏิเสธการรับส่งข้อมูลขาเข้าทั้งหมด และจะอนุญาตการรับส่งข้อมูลขาออกทั้งหมด แต่สามารถเพิ่มกฎแบบกำหนดเองเพื่อให้เหมาะกับความต้องการด้านการดำเนินการและความปลอดภัย เป็นแบบ Stateful ซึ่งหมายความว่าถ้ามี Request ขาออก (เช่น EC2 → Internet) ผ่าน SG ได้ → Response ขากลับเข้ามา จะถูกอนุญาต อัตโนมัติ โดยไม่ต้องใส่ Inbound Rule เพิ่มเติม

  • Internet gateway ใช้ในการเชื่อมต่อ VPC กับ Internet

    image.png
  • AWS Direct Connect เป็นบริการที่สร้างการเชื่อมต่อส่วนตัวแบบ Dedicated ระหว่างศูนย์ข้อมูลในองค์กรกับ VPC ช่วยให้สามารถลดค่าใช้จ่ายในส่วนของเครือข่าย และเพิ่มปริมาณ Bandwidth ที่สามารถส่งผ่านเครือข่ายได้

  • การสืบค้น DNS คือ การแปลงชื่อ Domain เป็นที่อยู่ IP
    ตัวอย่างเช่น หากต้องการเข้าชม Website ของ AnyCompany.cz ต้องป้อนชื่อ Domain ลงใน PC และคำขอนี้จะถูกส่งไปยัง Server DNS มันจะขอที่อยู่ IP กับ Website ของ AnyCompany จาก Web Server โดย Web Server จะตอบกลับโดยให้ที่อยู่ IP หมายเลข 193.84.128.201 สำหรับ Website ของ AnyCompany
5. พื้นที่เก็บข้อมูล:
  • Instance Storage เหมาะสำหรับข้อมูลชั่วคราวที่ไม่จำเป็นต้องเก็บไว้ในระยะยาว เมื่อหยุดหรือ Terminate Amazon EC2 Instance ระบบจะลบข้อมูลทั้งหมดที่เขียนที่ Attach ไว้

  • Amazon EBS เหมาะสำหรับข้อมูลที่ต้องเก็บรักษา เหมือนแยก Drive ออกจาก Computer Host ของ EC2 Instance

  • EBS Volume ต้องอยู่ใน AZ เดียวกันกับ Amazon EC2 Instance ที่ Attach ไว้
    ข้อมูลในระบบ File Amazon EFS สามารถเข้าถึงได้พร้อมกันจากทุก AZ ใน Region ที่ระบบ File ตั้งอยู่

  • Class ของพื้นที่เก็บข้อมูล S3 Standard-Infrequent Access (IA) เหมาะอย่างยิ่งสำหรับข้อมูลที่ไม่ได้มีการเข้าถึงบ่อยครั้ง แต่ต้องมีความพร้อมใช้งานสูงเมื่อจำเป็น ทั้ง S3 Standard และ S3 Standard-IA จัดเก็บข้อมูลไว้ใน AZ อย่างน้อย 3 แห่ง S3 Standard-IA มีความพร้อมใช้งานในระดับเดียวกับ S3 Standard แต่มีค่าบริการพื้นที่เก็บข้อมูลต่ำกว่า

  • Code:
    https://www.linkedin.com/pulse/understanding-amazon-s3-storage-classes-making-most-cloud-ajit-pisal
    1693393916325

    WtlDs4rh4ssfZSmfSZLpY6KLMfg.png

  • 🎯 คนที่เลือก Storage Class ไม่ถูก หรือไม่อยากมานั่งคอยเปลี่ยนเอง AWS ก็ทำ S3 Intelligent-Tiering มาเผื่อ
    หลักการคือ 👉 มันจะ “ย้าย File อัตโนมัติ” ระหว่าง Tier (เช่น Frequent, Infrequent, Archive) ตามพฤติกรรมการเข้าถึง File โดยไม่ต้องคิดเองว่าจะเก็บไว้ Class ไหน
    ทำงานยังไง:
    • เมื่อ Upload File เข้า Intelligent-Tiering → มันจะเริ่มเก็บไว้ใน Frequent Access Tier
    • ถ้า 30 วันไม่ได้ถูกอ่านเลย → มันจะย้ายไป Infrequent Access Tier (ถูกกว่า)
    • ถ้า 90 วันไม่ถูกอ่าน → ย้ายไป Archive Instant Access Tier
    • ถ้า 180 วันไม่ถูกอ่าน → ย้ายไป Archive Access หรือ Deep Archive Access ตามที่ตั้งค่าไว้
6. ความปลอดภัย
:cool:
 
Last edited:

PlAwAnSaI

Administrator
Security & Compliance:
  • ประโยชน์ของการใช้ AWS Cloud:
    • ตอบสนองต่อมาตรฐานสูงสุดด้านความเป็นส่วนตัวและความปลอดภัยของข้อมูล
    • จัดการ Key เข้ารหัส (Encryption Key) พร้อมตัวเลือกที่หลากหลาย
    • Scale ด้วยการมองเห็นที่มากขึ้น
    • ทำงานอัตโนมัติเพื่อเพิ่มความปลอดภัยและลดความเสี่ยง
    • ใช้การควบคุมและการติดตามในระดับละเอียด เช่น
      • ให้ User A อ่าน File จาก S3 Bucket ได้อย่างเดียว แต่ไม่สามารถลบ File ได้
      • ใช้ IAM Roles หรือ Policy แยกตาม App/Team เพื่อให้สิทธิ์เฉพาะที่จำเป็น (Least Privilege)
      • CloudWatch ติดตามการทำงานของ EC2, Lambda, RDS ฯลฯ พร้อมการตั้ง Alarm ถ้ามีค่าผิดปกติ
      • CloudTrail ติดตามว่าใครทำอะไรกับทรัพยากรใน AWS (Audit Log) เช่น ใครลบ EC2 Instance, ใครแก้ IAM Policy
      • AWS Config ตรวจสอบการตั้งค่า (Configuration) ของทรัพยากร และแจ้งเตือนถ้ามีการเปลี่ยนแปลงที่ไม่ตรงตามมาตรฐาน
    • ช่วยลดความจำเป็นในการทำงานด้วยตนเอง
    • ไม่จำเป็นต้องซื้อ Hardware ภายในองค์กร (On-premises) อีกต่อไป
    • ไม่ต้องจ่ายค่าบริการล่วงหน้าสำหรับ AWS แต่จะจ่ายตามการใช้งานจริง
      .
  • AWS มอบการควบคุมในระดับที่ละเอียด เพราะการควบคุมแบบเดียวไม่สามารถตอบโจทย์ลูกค้าทุกคนได้
    เมื่อลูกค้าเลือก AWS Region สำหรับจัดเก็บข้อมูล ข้อมูลจะไม่ถูกทำสำเนาหรือย้ายไปที่อื่น เว้นแต่ลูกค้าเป็นผู้เลือกเอง
    AWS ยังมอบเครื่องมือในการควบคุม การมองเห็น และบริการที่เป็นมิตรต่อการตรวจสอบ (Audit-friendly) เพื่อช่วยให้ลูกค้าสามารถปฏิบัติตามกฎหมายและข้อบังคับด้านความเป็นส่วนตัวของข้อมูลในแต่ละประเทศได้ โดยครอบคลุมตั้งแต่การควบคุมว่าใครสามารถเข้าถึงข้อมูลได้ ไปจนถึงการจัดการข้อมูลตลอด Lifecycle รวมถึงขั้นตอนการลบข้อมูลเมื่อหมดความจำเป็น

  • ลูกค้าเป็นผู้รับผิดชอบด้านความปลอดภัย ภายใน AWS Cloud ซึ่งรวมถึงการรักษาความปลอดภัยของเนื้อหา, ระบบ, และเครือข่ายของตนเอง เช่นเดียวกับที่ต้องทำกับ App ใน Data Center แบบ On-premises ลูกค้าจะยังคงต้องรับผิดชอบในการปกป้อง ความลับ (Confidentiality), ความถูกต้องครบถ้วน (Integrity) และ ความพร้อมใช้งาน (Availability) ของข้อมูลของตน

  • AWS ดูแล ความปลอดภัยของCloud
    • รักษาความปลอดภัยของศูนย์ข้อมูลทางกายภาพ (Physical)
    • ปกป้องโครงสร้างพื้นฐานระดับโลกที่ใช้ในการให้บริการทั้งหมดบน AWS Cloud โครงสร้างพื้นฐานนี้ครอบคลุมทั้ง Hardware, Software, ระบบเครือข่าย และสถานที่อย่างศูนย์ข้อมูล ที่ใช้ในการ Run บริการของ AWS
    • ปกป้องบริการของ AWS เอง เช่น การประมวลผล (Compute), การจัดเก็บข้อมูล (Storage), เครือข่าย (Networking), และฐานข้อมูล
  • ผู้ดูแลระบบ Cloud (Cloud Administrator) ต้องคำนึงถึงการจัดการสิทธิ์ผู้ใช้งานและการ Share ทรัพยากรในแต่ละวัน ส่วน AWS มีหน้าที่รับผิดชอบในการปกป้องโครงสร้างพื้นฐานระดับโลก ติดตั้งและ Update Patch Hardware Compute รวมถึงดูแลการตั้งค่าของอุปกรณ์โครงสร้างพื้นฐานของ AWS

  • บริการด้านความปลอดภัยและการปฏิบัติตามข้อกำหนด (Compliance) ของ AWS มี 6 หมวดหลัก ๆ
    1. Identity & Access Management – จัดการตัวตนและสิทธิ์การเข้าถึง เช่น IAM, SSO
      • IAM ใช้สำหรับ จัดการตัวตน (ผู้ใช้, App, ระบบ) และ สิทธิ์การเข้าถึงบริการหรือทรัพยากรใน AWS ได้อย่างปลอดภัยและรองรับการใช้งานในระดับใหญ่ (Scale) 👉 ระบบควบคุมว่า "ใคร" เข้าถึง "อะไร" ใน AWS ได้บ้าง และทำอะไรได้บ้าง เช่น ดู, แก้ไข, ลบ
    2. Detection – ตรวจจับความเสี่ยง การตั้งค่าที่ผิดพลาด ภัยคุกคาม หรือพฤติกรรมที่ไม่ปกติ เช่น GuardDuty, Security Hub
      • Security Hub ช่วยให้เห็นภาพรวมแบบครบถ้วนของสถานะความปลอดภัยและการปฏิบัติตามมาตรฐาน (Compliance) บน AWS ซึ่งจะช่วยในการจัดการการแจ้งเตือนด้านความปลอดภัย และทำการตรวจสอบความปลอดภัยแบบอัตโนมัติได้
    3. Network & App Protection – ป้องกันเครือข่ายและ App เช่น WAF, Shield
    4. Data Protection – ปกป้องข้อมูลด้วยการเข้ารหัสและควบคุมการเข้าถึง เช่น KMS, Macie
    5. Incident Response – การตอบสนองเมื่อเกิดเหตุด้านความปลอดภัย เช่น Detective เป็นเครื่องมือที่ช่วย สืบสวนเหตุการณ์ด้าน Security
    6. Compliance – บริการและเครื่องมือช่วยลูกค้าให้ทำตามมาตรฐานและกฎหมาย เช่น Artifact, Audit Manager, Config
      👉 แต่ละหมวดช่วยให้ลูกค้ามี การควบคุม ความมั่นใจ และการปฏิบัติตามข้อกำหนด ได้ง่ายขึ้น
      .
  • AWS Partner Solutions Finder เป็นเครื่องมือที่ช่วยให้ค้นหา AWS Partner ที่สามารถช่วยเร่งเส้นทางการใช้งาน Cloud ของลูกค้าได้ สามารถค้นหาได้ตาม พื้นที่ตั้ง (Location), Solution เฉพาะ, อุตสาหกรรม (Healthcare, Financial, etc.), และ Use Case ที่ต้องการ
Customer Questions:
  • ลูกค้ากังวลว่าข้อมูลจะไม่ปลอดภัย >
    โครงสร้างพื้นฐานหลักของ AWS ถูกสร้างขึ้นมาเพื่อตอบสนองความต้องการด้านความปลอดภัยของหน่วยงานทหาร, ธนาคารระดับโลก, และองค์กรที่มีความอ่อนไหวสูงอื่น ๆ โดยมีเครื่องมือด้านความปลอดภัยบน Cloud ที่ครอบคลุมจำนวนมากรองรับ ซึ่งรวมแล้วมีมากกว่า 300 บริการและ Feature ที่เกี่ยวข้องกับ ความปลอดภัย, การปฏิบัติตามข้อกำหนด (Compliance), และการกำกับดูแล (Governance)

  • ข้อมูลของลูกค้าจะเป็นส่วนตัวเพื่อป้องกันไม่ให้คนอื่นเข้าถึงหรือไม่? >
    Amazon และ AWS ให้ความสำคัญอย่างยิ่งต่อความเป็นส่วนตัวของลูกค้า และได้ดำเนินมาตรการทั้งด้าน Technique และด้านกายภาพเพื่อป้องกันการเข้าถึงโดยไม่ได้รับอนุญาต มี Team ผู้เชี่ยวชาญด้านความปลอดภัยระดับโลกคอยเฝ้าระวังและตรวจสอบระบบตลอด 24 ชั่วโมง 7 วันต่อสัปดาห์ เพื่อปกป้องข้อมูลของลูกค้า

  • ลูกค้าได้ยินข่าวว่ามีข้อมูลสำคัญรั่วไหล >
    หลักการสำคัญอย่างหนึ่งของ AWS คือการมอบความยืดหยุ่นให้ผู้พัฒนาสามารถปรับเปลี่ยนการตั้งค่าเริ่มต้น (Default Configuration) ให้เหมาะสมกับรูปแบบของ App ที่พวกเขากำลังสร้างขึ้นได้ อย่างไรก็ตาม เช่นเดียวกับการใช้งานในระบบ On-premises หรือตามที่อื่น ๆ เมื่อใดก็ตามที่ลูกค้าตั้งค่าการควบคุมการเข้าถึง (Access Control Configuration) ใหม่ ลูกค้าต้องมั่นใจว่าการตั้งค่านั้นปกป้องการเข้าถึงได้ตามที่ตั้งใจไว้ AWS มีบริการหลายอย่างที่ช่วยลูกค้าในการตรวจสอบ (Audit) และพิจารณาการเปลี่ยนแปลงการตั้งค่าเหล่านี้ เพื่อป้องกันไม่ให้เกิดการเปิดเผยข้อมูล (Data Exposure)

  • ลูกค้าจะได้มาตรฐาน HIPAA (ข้อมูลสุขภาพ) เลยหรือไม่ เมื่อย้าย App ไปยัง AWS Cloud? >
    ลูกค้าจะไม่ได้ เป็นไปตามข้อกำหนด (Compliant) โดยอัตโนมัติ ถึงแม้ AWS จะช่วยสนับสนุนให้ก้าวไปในเส้นทางนั้น แต่มันไม่ได้ทำให้ปฏิบัติตามข้อกำหนดอย่างสมบูรณ์ ลูกค้าจะต้องปฏิบัติตามข้อกำหนดด้านกฎระเบียบ (Regulatory Compliance) และ รับรองความปลอดภัย (Security Assurance) เองด้วย เป็นความรับผิดชอบร่วมกัน (Shared Responsibility) โดย AWS จะมีเครื่องมือและทรัพยากรให้ลูกค้าใช้เพื่อช่วยให้สอดคล้องตามข้อกำหนด แต่สุดท้ายแล้ว เป็นความรับผิดชอบของลูกค้าที่ต้องรู้และเข้าใจวิธีปฏิบัติเพื่อให้เป็นไปตามข้อกำหนดนั้น ๆ

  • จะจัดการความต้องการด้านความเป็นส่วนตัวและการควบคุมข้อมูลด้วย AWS ได้อย่างไร? >
    ตั้งแต่แรกเริ่ม แนวทางของ AWS คือการออกแบบระบบให้ลูกค้ามี การควบคุมข้อมูลได้อย่างเต็มที่ตั้งแต่ต้น โดยไม่ต้องแลกกับประสิทธิภาพหรือความสามารถอื่น ๆ ด้วยแนวทางนี้ ลูกค้าจึงสามารถตอบสนองต่อข้อกำหนดด้านกฎหมายและการจัดการข้อมูลของแต่ละประเทศได้ โดยไม่กระทบต่อประสิทธิภาพ ความสามารถในการสร้างสรรค์ และการขยายตัวของบริการ Cloud AWS

    AWS ยังนำเสนอนวัตกรรมต่าง ๆ ที่เน้นผู้ใช้งานเป็นศูนย์กลาง ทั้งในระดับโครงสร้างพื้นฐาน เช่น การออกแบบ Region, AWS Europe Sovereign Cloud, AWS Dedicated Local Zone ตลอดจนการพัฒนาบริการและ Feature ใหม่ ๆ เช่น AWS Nitro System, AWS Control Tower และทางเลือกในการเข้ารหัสข้อมูลหลายรูปแบบ เช่น External Key Store

    AWS มุ่งมั่นที่จะมอบเครื่องมือและ Feature ด้านการควบคุมข้อมูลที่ก้าวล้ำที่สุดให้แก่ลูกค้าทุกคน เพื่อให้มั่นใจได้ว่าการใช้งานบน Cloud เป็นไปตามข้อกำหนดของแต่ละประเทศได้อย่างมั่นคงและปลอดภัย

  • ลูกค้ามีการใช้ Software Third-party สำหรับความต้องการด้านความปลอดภัยบางส่วน จะสามารถใช้บน AWS ได้หรือไม่? >
    AWS มี Partner มากกว่า 100,000 ราย จากกว่า 150 ประเทศ ครอบคลุมทั้งผู้พัฒนา Software อิสระ (ISV) และผู้ให้บริการ SaaS ซึ่งหลายรายได้เผยแพร่ผลิตภัณฑ์ของตนเองบน AWS Marketplace เพื่อช่วยให้องค์กรทำงานด้านการจัดซื้อ (Procurement), การจัดเตรียมระบบ (Provisioning), และการกำกับดูแล (Governance) ได้ง่ายขึ้น Partner สามารถช่วยค้นหา Solution ที่ใช้อยู่แล้วบน Marketplace ได้

  • ลูกค้าพึ่งจะเริ่มใช้งาน AWS Cloud จะพัฒนาทักษะของพวกเขาได้อย่างไร? >
    AWS มีแหล่งเรียนรู้และการฝึกอบรม เช่น AWS Skill Builder ซึ่งเป็น Platform อบรม Online ของ AWS ที่ช่วยให้ Team สามารถพัฒนาทักษะด้าน AWS Cloud ได้อย่างต่อเนื่อง
:cool:
 
Last edited:

PlAwAnSaI

Administrator
  • สถานการณ์ที่ควรใช้ Amazon Relational Database Service (Amazon RDS):
    • การใช้ SQL เพื่อจัดระเบียบข้อมูล
    • การจัดเก็บข้อมูลในฐานข้อมูล Amazon Aurora
      .
  • Amazon DynamoDB คือบริการฐานข้อมูลแบบ Key-value และ Serverless ซึ่งหมายความว่าไม่จำเป็นต้อง Patch หรือจัดการ Server
    อาจประกอบด้วยคู่ข้อมูล เช่น “ชื่อ: John Doe”, “ที่อยู่: 123 Any Street” และ “เมือง: Anytown”
    ในฐานข้อมูลแบบนี้ สามารถเพิ่มหรือลบ Attribute (Column) จาก Item (Row) ในตารางได้ตลอดเวลา เพราะบาง Item ในตารางไม่จำเป็นต้องมีทุก Attribute

  • Amazon Redshift คือบริการคลังข้อมูลที่สามารถใช้เพื่อการวิเคราะห์ Big Data ใช้เพื่อรวบรวมข้อมูลจากแหล่งข้อมูลมากมาย และช่วยให้เข้าใจความสัมพันธ์และแนวโน้มในข้อมูล
6. ความปลอดภัย
  • ตัวอย่างงานที่เป็นความรับผิดชอบของลูกค้า:
    • การ Patch Software บน Amazon EC2 Instance
    • การกำหนดสิทธิ์สำหรับ Object Amazon S3
    • การกำหนดค่ากลุ่มมาตรการรักษาความปลอดภัยบน Amazon EC2 Instance
    • การฝึกอบรมพนักงานของบริษัทเกี่ยวกับวิธีใช้บริการของ AWS
    • การสร้างผู้ใช้และกลุ่มใน IAM
      .
  • ใน AWS มี 2 ระดับนโยบาย ที่ต้องเข้าใจคือ:
    .
    1. 🟦IAM Policy เอกสารที่ให้หรือปฏิเสธสิทธิ์ในบริการและทรัพยากรของ AWS ในระดับบัญชี Account
      • เอาไว้กำหนดสิทธิ์ในบัญชีเดียว
      • ใครจะทำอะไรได้บ้าง → Attach ให้ User, Group, หรือ Role
      • ตัวอย่าง:
        • Allow ให้ Dev ทำ s3: PutObject ใน S3 Bucket ชื่อ dev-bucket
        • หรือ Deny ให้ User บางคนใช้ EC2 ได้แค่ Region ap-southeast-1
      • อยู่ภายใต้ขอบเขตของบัญชี (AWS Account) เท่านั้น

        ใช้เมื่อ:
      • ต้องการจัดการสิทธิ์ผู้ใช้ในบัญชีเดียว
      • ควบคุมละเอียดว่าผู้ใช้/Role ตัวนี้ทำอะไรได้บ้าง
        .
    2. 🟩Service Control Policy (SCP) (ในระดับองค์กร Organization)
      • ใช้ใน AWS Organizations เท่านั้น
      • เป็น “กรอบใหญ่” หรือ Maximum Permission Boundary
      • บังคับใช้กับ OU, บัญชีสมาชิก (Member Account) หรือทั้งองค์กร รวมทั้ง Root User
      • ถึงแม้ IAM Policy ในบัญชียอมให้ทำ แต่ถ้า SCP ไม่ให้ → ก็ทำไม่ได้
      • แต่ถ้า SCP ให้ แต่ IAM Policy ไม่ให้ → ก็ยังทำไม่ได้ เช่นกัน
        → สิทธิ์ที่แท้จริง = สิทธิ์ที่ทั้งสองฝั่ง “Allow” พร้อมกัน

        ใช้เมื่อ:
      • องค์กรมีหลายบัญชี → ต้องตั้งข้อจำกัดระดับองค์กร
      • เช่น ห้ามทุกบัญชีสร้าง Resource นอก Region ap-southeast-1
      • หรือห้ามใช้บริการแพง ๆ เช่น Amazon Neptune ทุกบัญชี
        .
  • IAM Role = ตัวตนชั่วคราว + ชุดสิทธิ์
    เวลา สวมบทบาท (Assume Role) จะได้สิทธิ์ตามบทบาทนั้นแทนสิทธิ์เดิม พอหมด Session หรือเลิกใช้ Role สิทธิ์ก็หายไป → เหมาะกับงานที่ต้องใช้สิทธิ์พิเศษชั่วคราว เช่น
    • Team Dev ต้องแก้ไข Production ชั่วคราว
    • App หนึ่งต้องเข้าถึง S3 หรือ DynamoDB แต่ไม่ควรเก็บ Key ถาวร
    • บริการ Cross-account Access → เช่น บัญชี A ให้บัญชี B เข้าถึง S3 ของมันได้ผ่าน Role
      ต่างจาก IAM User → ผู้ใช้จะมี Credential และสิทธิ์ถาวร (จนกว่าจะถูกลบหรือเปลี่ยน)
      .
  • เมื่อมอบสิทธิ์โดยดำเนินการตามหลักการให้สิทธิ์เท่าที่จำเป็น (Least Privilege) จะป้องกันไม่ให้ผู้ใช้หรือบทบาทมีสิทธิ์มากเกินความจำเป็นในการปฏิบัติงานที่เฉพาะเจาะจง ตัวอย่างเช่น Cashier ในร้านกาแฟควรได้รับสิทธิ์เข้าถึงระบบเครื่องชำระเงิน เนื่องจากเป็น Best Practice ให้มอบชุดสิทธิ์ขั้นต่ำแก่ผู้ใช้และบทบาทใน IAM แล้วมอบสิทธิ์เพิ่มเติมตามความจำเป็น

  • ใน AWS Organizations ธุรกิจต่างๆ สามารถควบคุมสิทธิ์สำหรับบัญชีต่างๆ จากส่วนกลางได้โดยใช้นโยบายควบคุมบริการ (SCP) นอกจากนี้ ธุรกิจยังสามารถใช้ Feature การเรียกเก็บเงินแบบรวมทุกบัญชีใน AWS Organizations เพื่อรวมการใช้งานและรับใบเรียกเก็บเงินใบเดียวสำหรับบัญชี AWS หลายบัญชีได้

  • งานที่สามารถทำให้เสร็จสมบูรณ์ได้ใน AWS Artifact:
    • เข้าถึงรายงานการปฏิบัติตามข้อกำหนดของ AWS ตามความต้องการ
    • ตรวจสอบ ยอมรับ และจัดการข้อตกลงกับ AWS
      .
  • ขณะที่มีการส่งข้อมูลทางเครือข่ายเข้าสู่ App, AWS Shield ใช้ Technique การวิเคราะห์ที่หลากหลายเพื่อตรวจจับการโจมตีแบบ DDoS ที่อาจเกิดขึ้นแบบ Real-time พร้อมกับลดความเสียหายจากภัยคุกคามนั้นโดยอัตโนมัติ

  • AWS Key Management Service (KMS) ช่วยให้ลูกค้าสามารถดำเนินการเข้ารหัสข้อมูลผ่านการใช้ Key เข้ารหัสลับ
    Key เข้ารหัสลับคือ String ตัวเลขแบบสุ่มที่ใช้สำหรับการ Lock (การเข้ารหัส) และการปลด Lock (การถอดรหัส) ข้อมูล สามารถใช้ AWS KMS เพื่อสร้าง จัดการ และใช้งาน Key เข้ารหัสลับได้ นอกจากนี้ สามารถควบคุมการใช้ Key ในหลากหลายบริการและใน App ของลูกค้าได้เช่นกัน
7. การติดตามตรวจสอบ:
  • Amazon CloudWatch สามารถ:
    • ติดตามตรวจสอบการใช้งานและประสิทธิภาพทรัพยากร
    • ดูและติดตาม Metric จากหลายบริการหรือหลายทรัพยากร ได้ในหน้าจอเดียวของ CloudWatch Dashboard ทำให้ไม่ต้องสลับไปหลายหน้าหรือหลายเครื่องมือเพื่อดูข้อมูลแต่ละส่วน
      .
  • AWS CloudTrail สามารถ:
    • ติดตามดูประวัติกิจกรรมของผู้ใช้และการเรียกใช้ API ทั่วทั้งโครงสร้างพื้นฐาน AWS
    • โดยปกติแล้ว เหตุการณ์จะได้รับการ Update ใน CloudTrail ภายใน 15 นาที หลังจากที่เรียกใช้ API
    • กรองเหตุการณ์ได้โดยระบุเวลาและวันที่ที่มีการเรียกใช้ API เกิดขึ้น ผู้ใช้ที่ส่งคำขอดำเนินการ ประเภทของทรัพยากรที่เกี่ยวข้องในการเรียกใช้ API และอื่นๆ อีกมากมาย เพื่อช่วยในการวิเคราะห์และการแก้ไขปัญหาด้านการดำเนินการ
      .
  • AWS Trusted Advisor เป็น Web Service ที่ตรวจสอบสภาพแวดล้อม AWS และให้การแนะนำแบบ Real-time ตาม Best Practice ของ AWS ใน 5 หมวดหมู่ ได้แก่
    • การปรับค่าใช้จ่ายให้เหมาะสม
    • ประสิทธิภาพ เช่น หา EC2 Instance สำหรับการใช้งานสูงควรขยาย, เราจ่ายแพงเพื่อ Throughput สูง แต่ใช้งานไม่ถึง
    • การรักษาความปลอดภัย เช่น Amazon S3 Bucket ที่มีสิทธิ์เข้าถึงแบบ Public Access (ใครก็สามารถเข้าถึงได้)
    • ความทนทานต่อความล้มเหลว และ
    • Service Limit
8. ค่าบริการ & Support:
  • ในช่วงเวลา 12 เดือนหลังจากที่ลงทะเบียนบัญชี AWS เป็นครั้งแรก สามารถใช้บาง Service Free 12 เดือนได้ ตัวอย่างเช่น เก็บข้อมูล Amazon S3 Standard ได้ 5 GB, ใช้ Amazon EC2 ได้เดือนละ 750 ชั่วโมง, และปริมาณการถ่ายโอนข้อมูลออกของ Amazon CloudFront ได้เดือนละ 50 GB

  • รวมการใช้งานในบัญชีต่างๆ เพื่อรับส่วนลดค่าบริการตาม Volume

  • ใน AWS Budgets สามารถตั้งการแจ้งเตือนแบบกำหนดเองที่จะเตือนเมื่อมีการใช้บริการเกิน (หรือคาดการณ์ว่าจะเกิน) จากจำนวนงบประมาณที่ตั้งไว้

  • AWS Cost Explorer มีรายงานที่เป็นค่าเริ่มต้นเกี่ยวกับค่าใช้จ่ายและการใช้งานของ AWS ที่มีค่าใช้จ่ายสูงสุด 5 บริการแรก โดยสามารถใช้ตัวกรองและกลุ่มแบบกำหนดเองเพื่อวิเคราะห์ค่าใช้จ่ายและข้อมูลได้อย่างรวดเร็ว สามารถแสดงผลด้วยภาพ ตัวอย่างเช่น สามารถดูการใช้งานทรัพยากรในระดับรายชั่วโมงได้

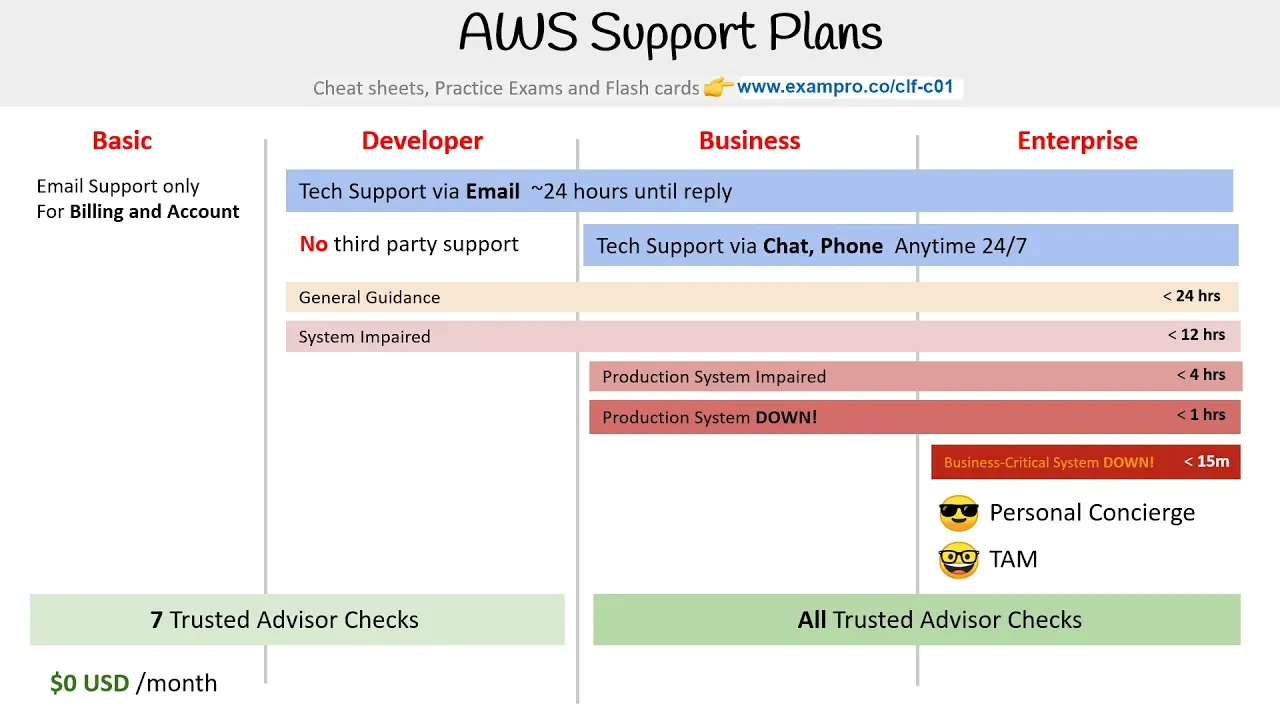
  • Basic Support หรือ Developer Support → จะเข้าถึง AWS Trusted Advisor ได้ เฉพาะหมวด Service Limit กับ Security บางรายการ เท่านั้น
    ส่วน Business เป็นแผน Support ที่มีค่าใช้จ่ายถูกที่สุดที่ → จะได้ Full Trusted Advisor Check ครบทั้ง 5 หมวด

    1*0oiq_clgqRoPcBdzECF3pQ.jpeg

  • Technical Account Manager (TAM) มีให้บริการเฉพาะลูกค้า AWS ที่ใช้แผน Support แบบ Enterprise On-Ramp และ Enterprise เท่านั้น
    TAM จะให้คำแนะนำ การตรวจสอบสถาปัตยกรรม และจะสื่อสารกับบริษัทลูกค้าอย่างต่อเนื่อง ขณะที่ลูกค้าวางแผน ติดตั้งใช้งาน และเพิ่มประสิทธิภาพ App

  • AWS Marketplace เป็น Catalog Digital ที่มีรายชื่อ Software นับพันรายการจากผู้จำหน่าย Software อิสระ (ISV) สามารถใช้ AWS Marketplace เพื่อค้นหา ทดสอบ และซื้อ Software ที่ทำงานบน AWS ได้
9. การย้ายข้อมูล:
  • Framework การนำ AWS Cloud ไปใช้งาน จัดกลุ่มความสามารถต่างๆ เป็นมุมมอง 6 ด้าน ได้แก่ ธุรกิจ, บุคลากร, การกำกับดูแล, Platform, การรักษาความปลอดภัย, และการดำเนินงาน:
    • Platform ช่วยให้ออกแบบ นำไปใช้ และเพิ่มประสิทธิภาพโครงสร้างพื้นฐานของ AWS ตามเป้าหมายทางธุรกิจ ยังรวมถึงหลักในการนำ Solution ใหม่ๆ ไปใช้ และการย้าย Workload ในองค์กรไปยังระบบ Cloud
    • ความปลอดภัยช่วยให้จัดโครงสร้างการเลือก, การนำสิทธิ์ไปใช้, และพบส่วนที่ไม่เป็นไปตามข้อกำหนดและวางแผนโครงการรักษาความปลอดภัยอย่างต่อเนื่องได้
    • การดำเนินงาน มุ่งเน้นไปที่การกู้คืน Workload ด้าน IT เพื่อตอบสนองความต้องการของผู้มีส่วนได้ส่วนเสียทางธุรกิจ ยังประกอบด้วยหลักการสำหรับการดำเนินการในระบบ Cloud โดยใช้ Best Practices เพื่อให้มีความคล่องตัวด้วย
:cool:
 
Last edited:

PlAwAnSaI

Administrator
  • กลยุทธ์ในการย้าย App ได้แก่ การย้าย Host (Rehosting), การเปลี่ยน Platform (Re-platforming), การปรับโครงสร้างใหม่ (Refactoring)/การออกแบบสถาปัตยกรรมใหม่ (Rearchitecting), การซื้อทดแทน (Repurchasing), การเก็บไว้ที่เดิม (Retaining) และการเลิกใช้ (Retiring)
    • Repurchasing คือการนำ App Version บน Cloud เช่น Software ที่พบใน AWS Marketplace (SaaS) มาใช้แทน App ที่มีอยู่ (เช่น ย้ายจาก CRM เดิมไปใช้ Salesforce)
    • Refactoring / Re-architecting เป็นการเปลี่ยนแปลงวิธีการออกแบบสถาปัตยกรรมและพัฒนา App ซึ่งโดยทั่วไปจะใช้ Feature แบบ Cloud-Native
      .
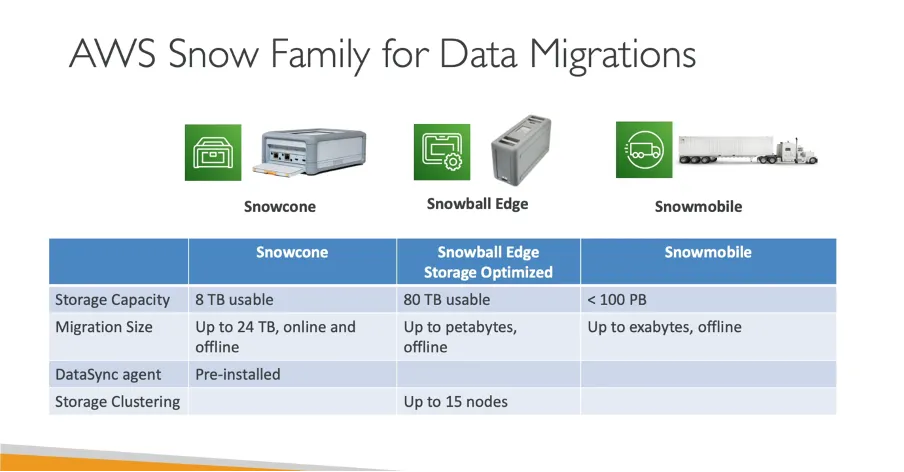
  • Snowball Edge Storage Optimized เป็นอุปกรณ์ที่ช่วยให้ถ่ายโอนข้อมูลจำนวนมากเข้าและออกจาก AWS ได้ มีพื้นที่เก็บข้อมูล HDD ที่ใช้งานได้ขนาดไม่เกิน 80 TB
  • AWS Snowmobile เป็นบริการที่ใช้สำหรับการถ่ายโอนข้อมูลไปยัง AWS ได้สูงสุดถึง 100 PB แต่ละ Snowmobile เป็น Container ขนส่งยาว 45 Foot ที่ใช้รถบรรทุกพ่วงในการลากจูง
    0*_1CNP67kbn3nGEdC.png


  • Amazon SageMaker ช่วยให้เริ่มทำงานใน Project Machine Learning ได้อย่างรวดเร็วและง่ายดาย ไม่จำเป็นต้องปฏิบัติตามกระบวนแบบเดิมในการรวบรวมเครื่องมือและ Workflow ที่แยกจากกันด้วยตนเอง

  • Amazon Augmented AI (Amazon A2I) มี Workflow การตรวจสอบโดยมนุษย์ในตัวสำหรับกรณีใช้งาน Machine Learning ทั่วไป เช่น การกลั่นกรองเนื้อหาและการแยกข้อความจากเอกสาร และ Amazon A2I ยังช่วยให้ผู้ใช้สร้าง Workflow ของตนเองสำหรับ Model Machine Learning ที่สร้างบน Amazon SageMaker หรือเครื่องมืออื่นๆ ได้อีกด้วย

  • ใน Amazon Lex สามารถสร้าง, ทดสอบ, และติดตั้งใช้งาน Chatbot เชิงสนทนาเพื่อใช้ใน App ของลูกค้าได้อย่างรวดเร็ว
10. กระบวนการย้ายไปยังระบบ Cloud:
  • Well-Architected Framework อิงตามเสาหลัก 6 ข้อดังต่อไปนี้:
    1. ความเป็นเลิศในการดำเนินการ - ประกอบด้วยความสามารถในการเรียกใช้ Workload อย่างมีประสิทธิภาพและได้รับข้อมูลเชิงลึกเกี่ยวกับการดำเนินการ
    2. ความปลอดภัย
    3. ความเสถียร - มุ่งเน้นไปที่ความสามารถของ Workload ในการใช้งาน Function ที่ต้องการได้อย่างสม่ำเสมอและถูกต้อง
    4. ประสิทธิภาพการทำงาน - จะมุ่งเน้นไปที่การใช้ทรัพยากรการประมวลผลอย่างมีประสิทธิภาพเพื่อตอบสนองความต้องการของระบบ และเพื่อรักษาประสิทธิภาพนั้นไว้เมื่อความต้องการเปลี่ยนแปลงไป และ Technology มีการพัฒนา
    5. การปรับค่าใช้จ่ายให้เหมาะสม
    6. ความยั่งยืน
      .
  • ประโยชน์ 6 ข้อของการประมวลผลบน Cloud ได้แก่:
    1. เปลี่ยนค่าใช้จ่ายล่วงหน้าให้เป็นค่าใช้จ่ายตามการใช้งาน
    2. ได้รับข้อดีจากการประหยัดต่อขนาด (Economies of Scale) ระดับมหาศาล - ยิ่งมีลูกค้าใช้ Cloud เยอะ AWS ก็ยิ่งซื้ออุปกรณ์และสร้างระบบในปริมาณมาก ต้นทุนเฉลี่ยต่อหน่วยถูกลง (เหมือนซื้อของราคาส่ง แถมยังหาร ค่าบำรุงรักษา, ค่าไฟ, ค่า Cooling เฉลี่ยออกไปหลายแสนลูกค้า)
    3. ไม่ต้องคาดเดาขีดความสามารถ
    4. เพิ่มความเร็วและความคล่องตัว
    5. เลิกใช้เงินไปกับการบำรุงรักษาศูนย์ข้อมูล
    6. ให้บริการทั่วโลกในเวลาเพียงไม่กี่นาที
11. Certified Cloud Practitioner:
  • การสอบ AWS Certified Cloud Practitioner จะแจ้งผลเป็นคะแนนตั้งแต่ 100 – 1,000 คะแนน โดยผ่านขั้นต่ำคือ 700

  • ตัวอย่างหัวข้อที่รวมอยู่ในการสอบ: ความปลอดภัยและการปฏิบัติตามข้อกำหนด, การเรียกเก็บเงินและค่าบริการ

Migration Business Case:
Overview:
  • Business Case เป็นเหมือน จุดอ้างอิง (Baseline) ใช้เปรียบเทียบว่าถ้าธุรกิจยังคงอยู่ในระบบปัจจุบัน (On-premises เหมือนเดิม) จะได้มูลค่าอะไรบ้าง ถ้าย้ายไปใช้งานและดำเนินการบน AWS Cloud จะได้มูลค่าอะไรบ้าง เอาไว้ใช้วัดว่า “คุ้มไหม” ระหว่าง อยู่เหมือนเดิม กับ ย้ายไป AWS

  • AWS Partner สามารถช่วยทำ Case ได้ตั้งแต่ วิเคราะห์คุณค่า (Analysis) → Case คร่าวๆ (Directional) → Case ละเอียดพร้อมตัวเลขเลย (Detailed)

  • การวิเคราะห์คุณค่าทางธุรกิจ (Business Value Analysis) มักจะทำในช่วงต้นของการขาย เหมาะสำหรับเวลาที่ลูกค้าต้องการ ทำความเข้าใจในภาพรวมกว้างๆ ก่อน ว่าการย้ายไปใช้ AWS จะมีประโยชน์อะไรบ้าง ทำไมถึงดี โดยยังไม่ลงลึกเรื่องตัวเลขค่าใช้จ่ายจริงจัง

  • องค์ประกอบหลักของการ Migrate คือ ประเมิน → เตรียม → ย้ายและปรับปรุง
    • การย้ายและปรับปรุงไม่ใช่แค่ย้ายขึ้น AWS จะมีการสร้าง Detailed Business Case (แผนละเอียด) ขึ้นมา ไว้ใช้เป็น Roadmap (คู่มือ) สำหรับการย้ายหรือปรับปรุง Platform ของลูกค้า
Analysis:
  • AWS แนะนำให้การทำ Business Value Analysis (เปรียบเทียบคุณค่าหรือผลประโยชน์จากการใช้ AWS) ครอบคลุมอย่างน้อย 3 ปี และ 5 ปีถือเป็น Best Practice เพื่อเห็นผลความคุ้มค่าในระยะยาว เช่น เรื่อง ค่าใช้จ่ายที่ลดลง, ความยืดหยุ่น, ความสามารถในการขยายระบบ

  • การทำ Business Case ให้ได้ผล ต้อง ดึงคนที่เกี่ยวข้องเข้ามาตั้งแต่ต้น + ทำร่วมกับลูกค้า ให้ลูกค้ามีส่วนร่วมและเป็นเจ้าของ Business Case เอง + ใช้ข้อมูลอ้างอิงจริง + Check ความเป็นปัจจุบัน ถูกต้อง และครบถ้วนของข้อมูล

  • การทำ Business Value Analysis ต้องเก็บข้อมูล Downtime, จำนวน Server ที่มีอยู่ + Storage ต่อ Server + Network (Bandwidth, การเชื่อมต่อ) + จำนวน Team งาน เป็นขั้นต่ำ เพื่อใช้วิเคราะห์มูลค่าทางธุรกิจจากการย้ายไป AWS

  • วิธีที่ง่ายที่สุดในการรวบรวมข้อมูลของลูกค้าแบบ Manual คือการใช้ Data Collection Sheet (แบบ Form เก็บข้อมูล)

  • หลังจากวิเคราะห์ต้นทุนและการประหยัดค่าใช้จ่ายเสร็จแล้ว ต้อง สรุปเป็นภาพรวม ให้ลูกค้าเห็นชัดเจนว่า ถ้าใช้ AWS จะ ประหยัดได้เท่าไหร่ คุ้มค่าในกี่ปี และมีประโยชน์อะไรเพิ่มขึ้นบ้าง
Directional:
  • Directional Business Case จะต่อยอดจาก Business Value Analysis โดยเพิ่มการพิจารณา ต้นทุนในการย้ายระบบ (Migration Cost) เข้ามาด้วย จากเดิมที่ดูแค่ “ประโยชน์ที่ได้จากการย้ายไป AWS” → Directional Business Case จะบอกด้วยว่า “ค่าใช้จ่ายที่จะเกิดขึ้นในการย้ายระบบ” มีเท่าไหร่ เพื่อให้ภาพรวมสมจริงขึ้น

  • High-level Comparison จะรวมถึง การเปรียบเทียบต้นทุนระหว่างสภาพแวดล้อมปัจจุบันกับการย้ายไปใช้ AWS

  • Directional Business Case เหมาะกับสถานการณ์ที่ลูกค้าอยากเห็น “ประมาณการเชิงกลยุทธ์” (มีผู้บริหารให้การสนับสนุน เข้าใจต้นทุนการย้ายระบบ และขอดูตัวเลขในระดับภาพรวมก่อน) ไม่ต้องละเอียดลึก แต่พอให้ตัดสินใจต่อได้ว่าจะไปต่อกับ AWS หรือไม่

  • ประสิทธิภาพการทำงานของพนักงาน (Staff Productivity) หมายถึง การปรับปรุงประสิทธิภาพของคนในการทำงาน โดยวัดตาม หน้าที่ (Function) และตาม งานแต่ละงาน (Task-by-task) ดูว่า พนักงานใช้เวลาน้อยลงหรือทำงานได้เร็วขึ้นแค่ไหน เมื่อมีการเปลี่ยนไปใช้ระบบ/เครื่องมือใหม่ เช่น AWS

  • การใช้ Ratios Method หมายถึง เอาตัวเลข Headcount (จำนวนพนักงานในแต่ละ Team/แผนก) มาคำนวณเป็นอัตราส่วน เพื่อวัด Staff Productivity (ประสิทธิภาพการทำงานของบุคลากร)
    เช่น
    • ลูกค้ามีพนักงาน IT 10 คน ทำงาน Support Server On-premises
    • หลังย้ายมา AWS ใช้ Automation แล้วเหลือแค่ 5 คนที่ต้องดูแล
      ➡ Productivity Ratio = 10 ÷ 5 = 2 เท่า (ประสิทธิภาพดีขึ้น 100%)
      .
  • Operational Resilience หมายถึง ความสามารถในการดำเนินธุรกิจได้ต่อเนื่องไม่สะดุด (Business Continuity) ต่อให้มีเหตุการณ์ไม่คาดคิด เช่น ระบบล่ม, ความผิดพลาดของคน, หรือภัยพิบัติ มุ่งเน้นไปที่ความพร้อมใช้งาน (Availability) และความปลอดภัย (Security)

  • Business Agility หมายถึง ความสามารถในการปรับตัวทางธุรกิจ โดยทำงานเร็ว สามารถปล่อย Feature ใหม่และ App ได้เร็วขึ้น พร้อมทั้งมีความผิดพลาดน้อย

  • AWS จะช่วยเสนอว่า ควรใช้ EC2 ประเภทไหนที่เหมาะสมที่สุด ทั้ง Spec และตัวเลือกการจ่ายเงิน

  • ถ้าลูกค้าไม่รู้ตัวเลขจริง AWS จะใส่ค่าเฉลี่ยหรือค่ามาตรฐานให้ก่อน เพื่อไม่ให้การทำ Business Case หยุดชะงัก

  • สามารถคำนวณต้นทุนได้ 2 มุมมอง: แบบดูการใช้งานตามค่าเฉลี่ยจริง หรือแบบดูเต็มความจุที่ On-premises รองรับได้

  • ต้องมีการเลือกวิธีการจ่ายเงิน (Payment Type) อย่างน้อยหนึ่งแบบ เพื่อให้ระบบสามารถ คำนวณราคา EC2 ได้ถูกต้อง

  • TCO (Total Cost of Ownership) Analysis Report ของ AWS จะให้ทั้ง ตัวเลขค่าใช้จ่ายจริง + % ที่ลดลง เพื่อให้เข้าใจง่ายขึ้นในการตัดสินใจลงทุน

  • Partner สามารถใช้ Migration Evaluator หรือ Migration Portfolio Assessment (MPA) เพื่อประเมินความพร้อมในการย้ายระบบ (Migration Readiness) ได้
Detailed:
  • สถานการณ์ที่เหมาะสมสำหรับการใช้ Detailed Business Case คือ👉 “ลูกค้าได้จัดสรรทรัพยากรภายในเพื่อสร้าง Detailed Business Case และแผนการย้ายระบบ (Migration Plan)

  • การทำ Detailed Business Case ใช้เวลาประมาณ 3 - 4 เดือน ตั้งแต่เริ่มต้นจนส่งมอบเสร็จสิ้น

  • ส่วนการเปรียบเทียบเชิงลึกของแผนธุรกิจแบบละเอียดจะรวมถึงสรุปการลงทุนและค่าใช้จ่ายประจำปีที่ต่อเนื่อง

  • การย้ายระบบอาจอยู่ในรูปแบบของการประเมิน ที่ให้รายละเอียดเกี่ยวกับความสามารถทางธุรกิจและทาง Technique ของลูกค้า
:cool:
 
Last edited:

PlAwAnSaI

Administrator
  • ข้อมูลเพิ่มเติมที่จำเป็นสำหรับการทำ Business Case แบบละเอียด ได้แก่ การทำแผนที่ความเชื่อมโยงของ App และกลยุทธ์การย้ายระบบ, ค่าใช้จ่ายด้าน License และการ Support, และ Program ของ AWS ที่เกี่ยวข้อง

  • การแบ่งการย้ายระบบเป็นลำดับ (Migration Waves), การจัดลำดับความสำคัญของ App (App Prioritization) และการจัดกลุ่มตามความเชื่อมโยง (Dependency Groups) ล้วนเป็นส่วนหนึ่งของขั้นตอน Plan ใน MPA

ความปลอดภัย:

ความปลอดภัยของข้อมูล คือ การปกป้องความปลอดภัยของข้อมูล: ความลับขององค์กร ข้อมูลส่วนบุคคล

องค์ประกอบหลักคำอธิบาย
การรักษาความลับ (C)ตรวจสอบให้แน่ใจว่าข้อมูลสามารถเข้าถึงได้เฉพาะผู้ที่มีสิทธิ์เท่านั้น
ความสมบูรณ์ (I)รักษาความสมบูรณ์และความถูกต้องของข้อมูล ตรวจสอบให้แน่ใจว่าข้อมูลไม่ได้
เสียหายหรือถูกแก้ไขอย่างไม่เหมาะสม
ความพร้อมใช้งาน (A)ตรวจสอบให้แน่ใจว่าข้อมูลและระบบสามารถเข้าถึงและใช้งานได้เมื่อจำเป็น
โดยผู้ใช้ที่ได้รับอนุญาต

ISO/IEC 27001 (หลักปฏิบัติสำหรับการจัดการความปลอดภัยของข้อมูล)


ความเสี่ยงในด้านความปลอดภัยของข้อมูล
  • ภัยคุกคาม คือ สาเหตุที่อาจก่อให้เกิดเหตุการณ์ไม่พึงประสงค์ ซึ่งอาจส่งผลเสียต่อระบบหรือสินทรัพย์ข้อมูล
  • ช่องโหว่ หมายถึง จุดอ่อนหรือช่องว่างในมาตรการป้องกัน หรือการควบคุมความปลอดภัยที่อาจถูกโจมตีโดยภัยคุกคามได้
หมวดหมู่คำอธิบาย
ภัยคุกคามภัยคุกคามโดยเจตนาการโจมตี
ภัยคุกคามโดยอุบัติเหตุความผิดพลาดของมนุษย์
ภัยคุกคามจากสิ่งแวดล้อมภัยพิบัติทางธรรมชาติ
ช่องโหว่SoftwareBug
กระบวนการขององค์กรนโยบายที่อ่อนแอ
ลักษณะทางกายภาพสถานที่ที่เสี่ยงต่อภัยพิบัติ

มาตรการรักษาความปลอดภัยข้อมูล
หมวดหมู่คำอธิบาย
โครงสร้างพื้นฐานUpdate Software ให้ทันสมัยอยู่เสมอด้วยการติดตั้ง Patch เป็นประจำ
ติดตั้ง Firewall ระบบตรวจจับ/ป้องกันการบุกรุก (IDS/IPS)
และ Software ป้องกัน Virus
ใช้งาน SIEM (ระบบจัดการข้อมูลและเหตุการณ์ด้านความปลอดภัย)
การตรวจสอบสิทธิ์ตั้งรหัสผ่าน
ระบบการตรวจสอบสิทธิ์
การตรวจสอบสิทธิ์แบบหลายปัจจัย (MFA)
การปกป้องข้อมูลใช้หลักการให้สิทธิ์ขั้นต่ำ (Least-privilege)
เข้ารหัสข้อมูลที่ละเอียดอ่อนทั้งในขณะจัดเก็บและขณะส่งผ่าน
มอบหมายการจัดเก็บข้อมูลให้กับผู้ให้บริการ Cloud ที่เชื่อถือได้

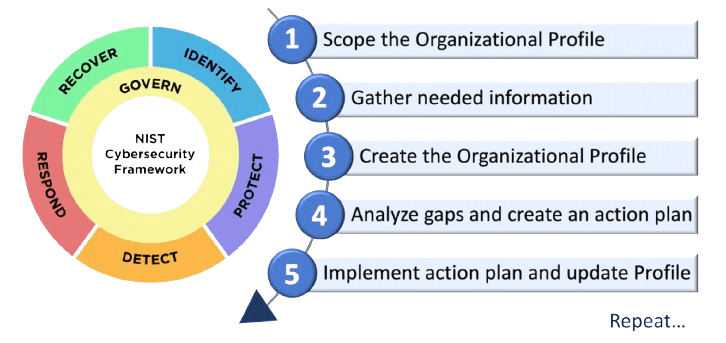
Framework ความปลอดภัยทาง Cyber ของ NIST (CSF):

nist-csf-profile.png


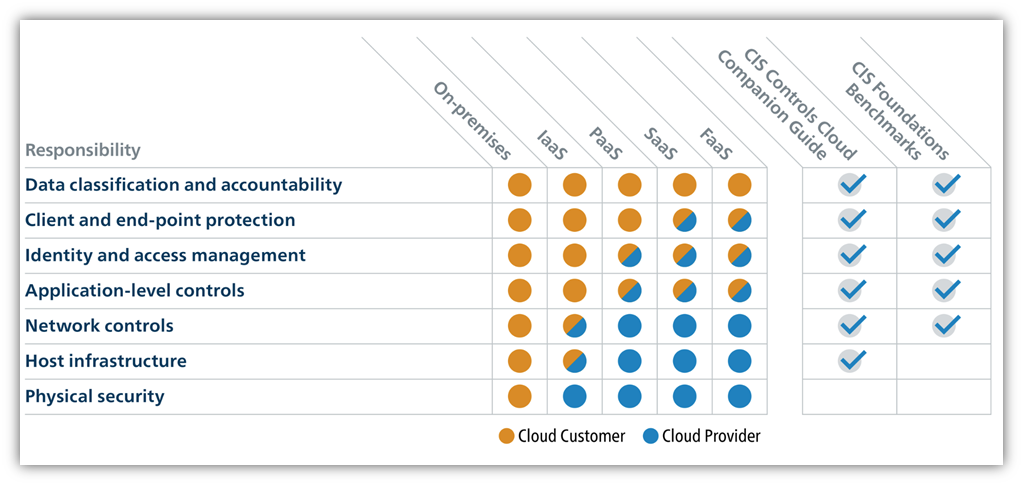
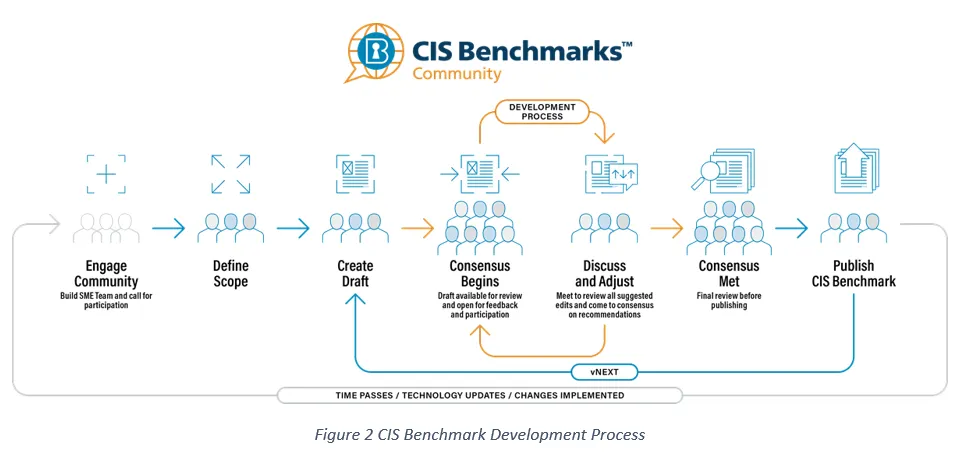
เกณฑ์มาตรฐาน CIS:
cissecurity-penetration-testing-graphic.png


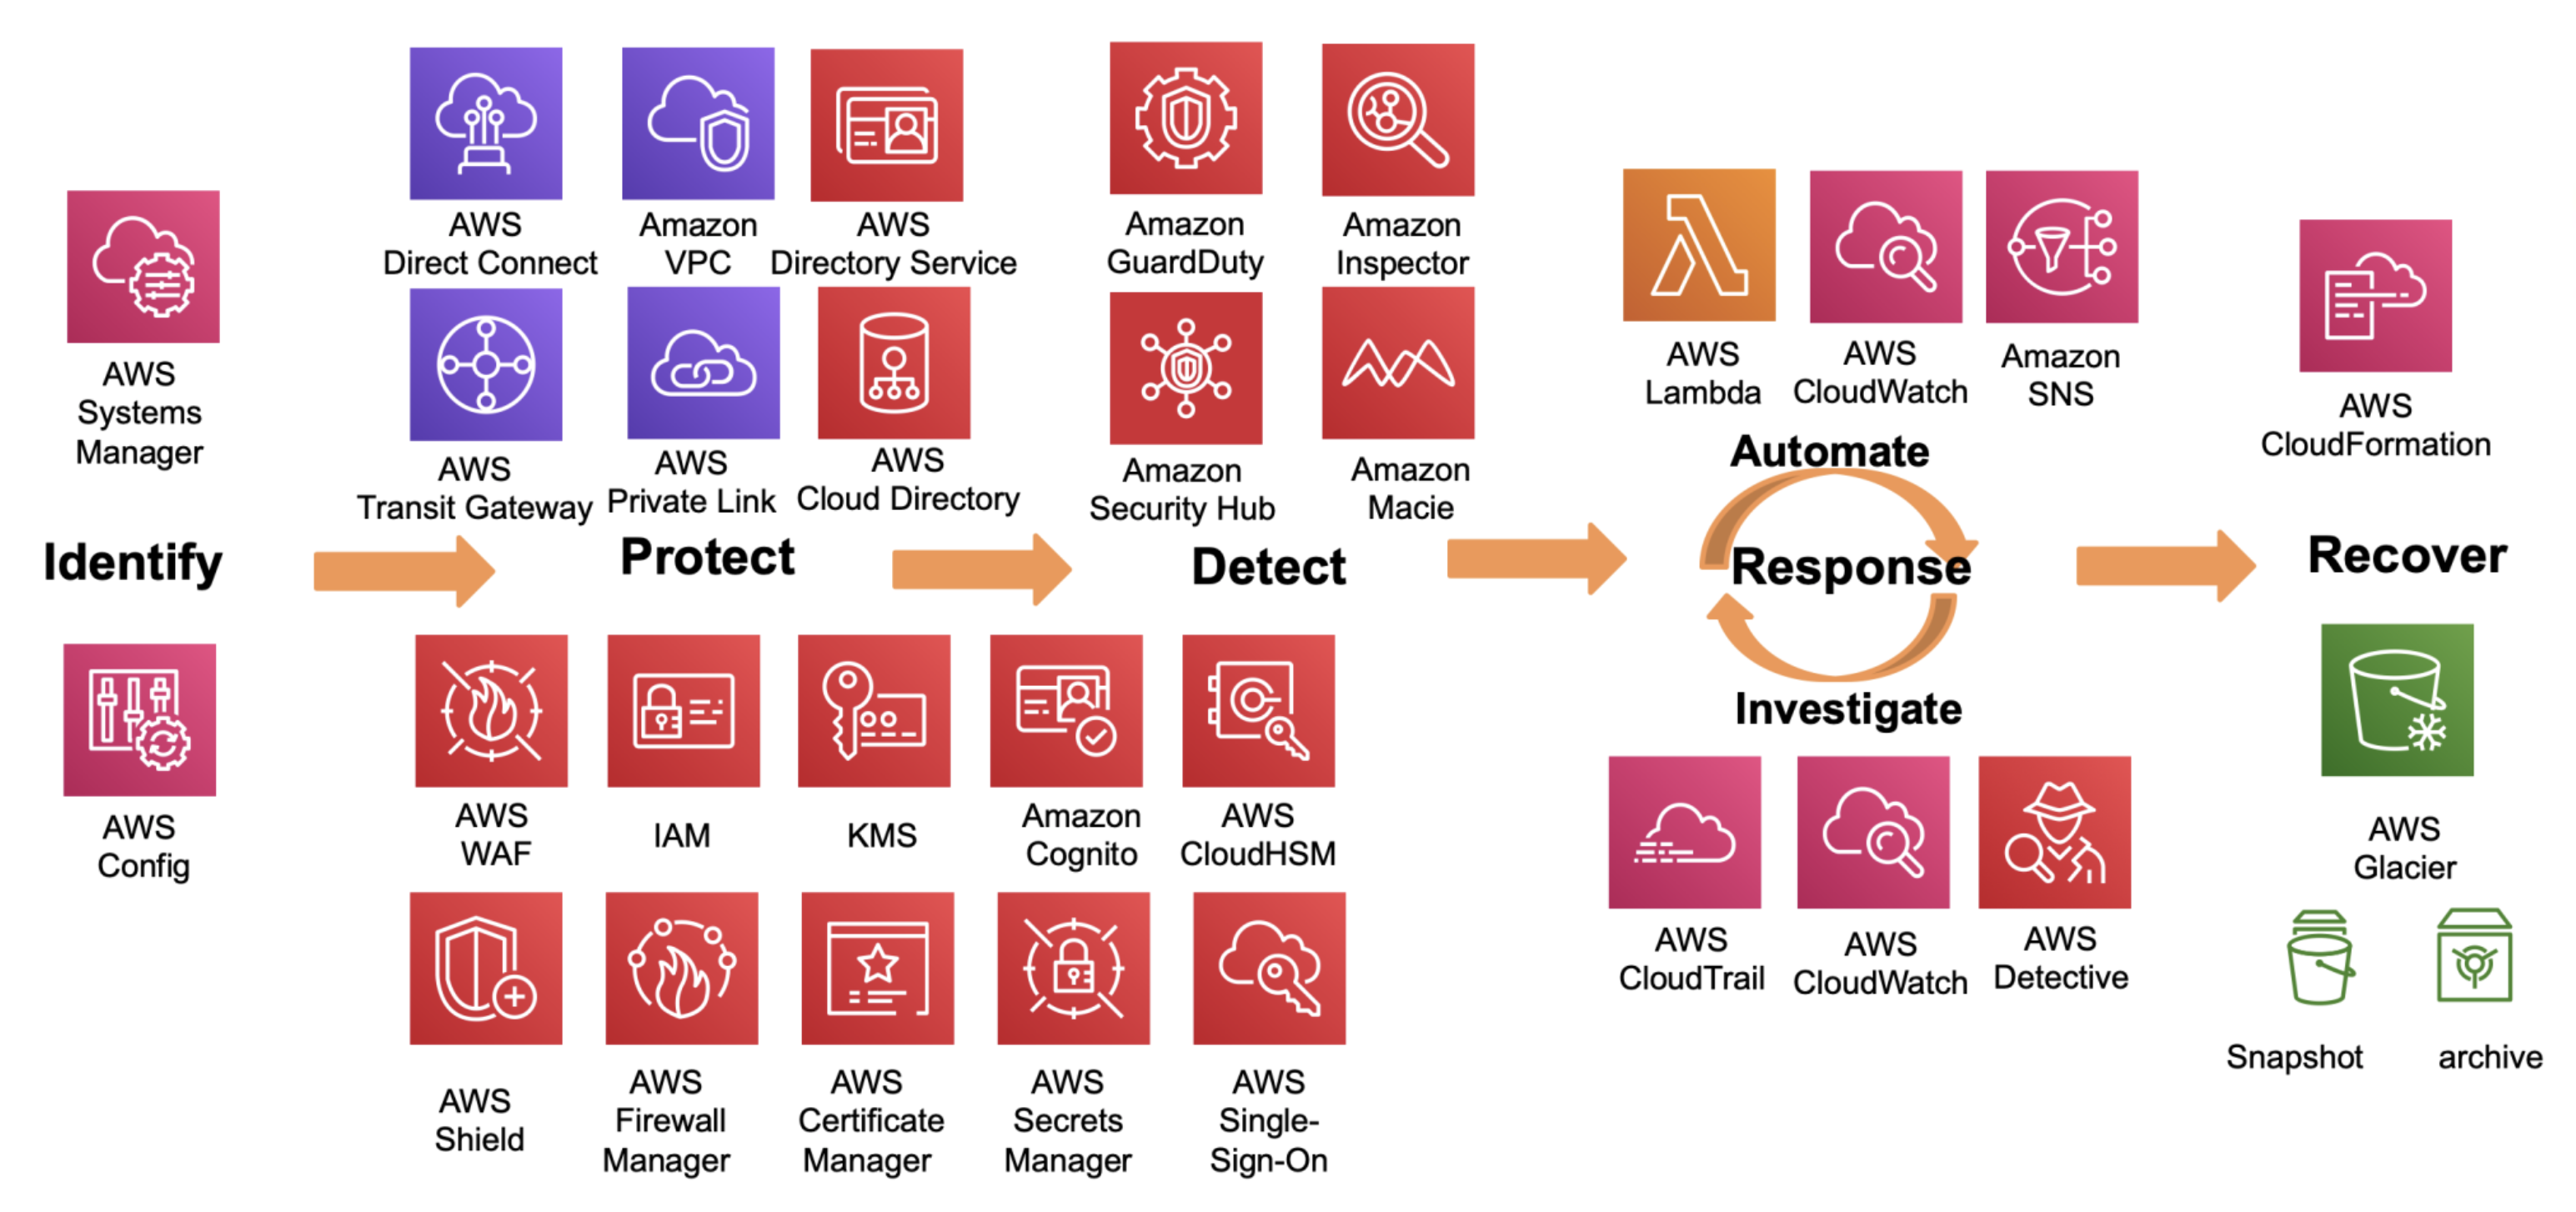
การตรวจจับภัยคุกคามและการตอบสนองต่อเหตุการณ์:
  1. การตรวจจับภัยคุกคาม:
    1. Amazon Macie
    2. Amazon GuardDuty
    3. Amazon Inspector
    4. AWS Security Hub
    5. Amazon Detective
  2. การตอบสนองต่อเหตุการณ์:
    1. AWS Systems Manager
    2. Amazon EventBridge
    3. AWS Lambda
Prevention / Proactive <> Detection / Reactive

NIST CSF:
solution_security_09.png

Amazon Macie:
  • บริการรักษาความปลอดภัยข้อมูลที่ใช้ ML และการจับคู่รูปแบบเพื่อค้นหา จัดประเภท และช่วยปกป้องข้อมูลสำคัญที่จัดเก็บไว้ใน S3
  • บริการที่จัดการอย่างเต็มรูปแบบ (Fully Managed Service): เปิดใช้งานได้จาก Console
  • ให้ข้อมูลเชิงลึกภายใน 48 ชั่วโมง:
    • ผลการค้นพบเกี่ยวกับข้อมูล Sensitive
    • การประเมินตามนโยบายความปลอดภัย
  • การตรวจสอบข้อมูลที่ละเอียดอ่อน:
    • ML และการจับคู่รูปแบบเพื่อตรวจจับและจำแนกข้อมูลที่ละเอียดอ่อน
    • ตัวระบุข้อมูล (ที่จัดการและกำหนดเอง)
    • เช่น ข้อมูลประจำตัว ข้อมูลทางการเงิน ข้อมูลส่วนบุคคลที่ระบุตัวตนได้ (PII) และข้อมูลสุขภาพส่วนบุคคล (PHI)
  • https://docs.aws.amazon.com/macie/latest/user/mdis-reference-quick.html
  • สามารถตรวจพบ:
    • ข้อมูลที่เข้าถึงได้โดยสาธารณะ
    • ข้อมูลที่ไม่ได้เข้ารหัส
    • Share กับบัญชีภายนอกองค์กร (OU) หรือรายการที่เชื่อถือได้ของคุณ

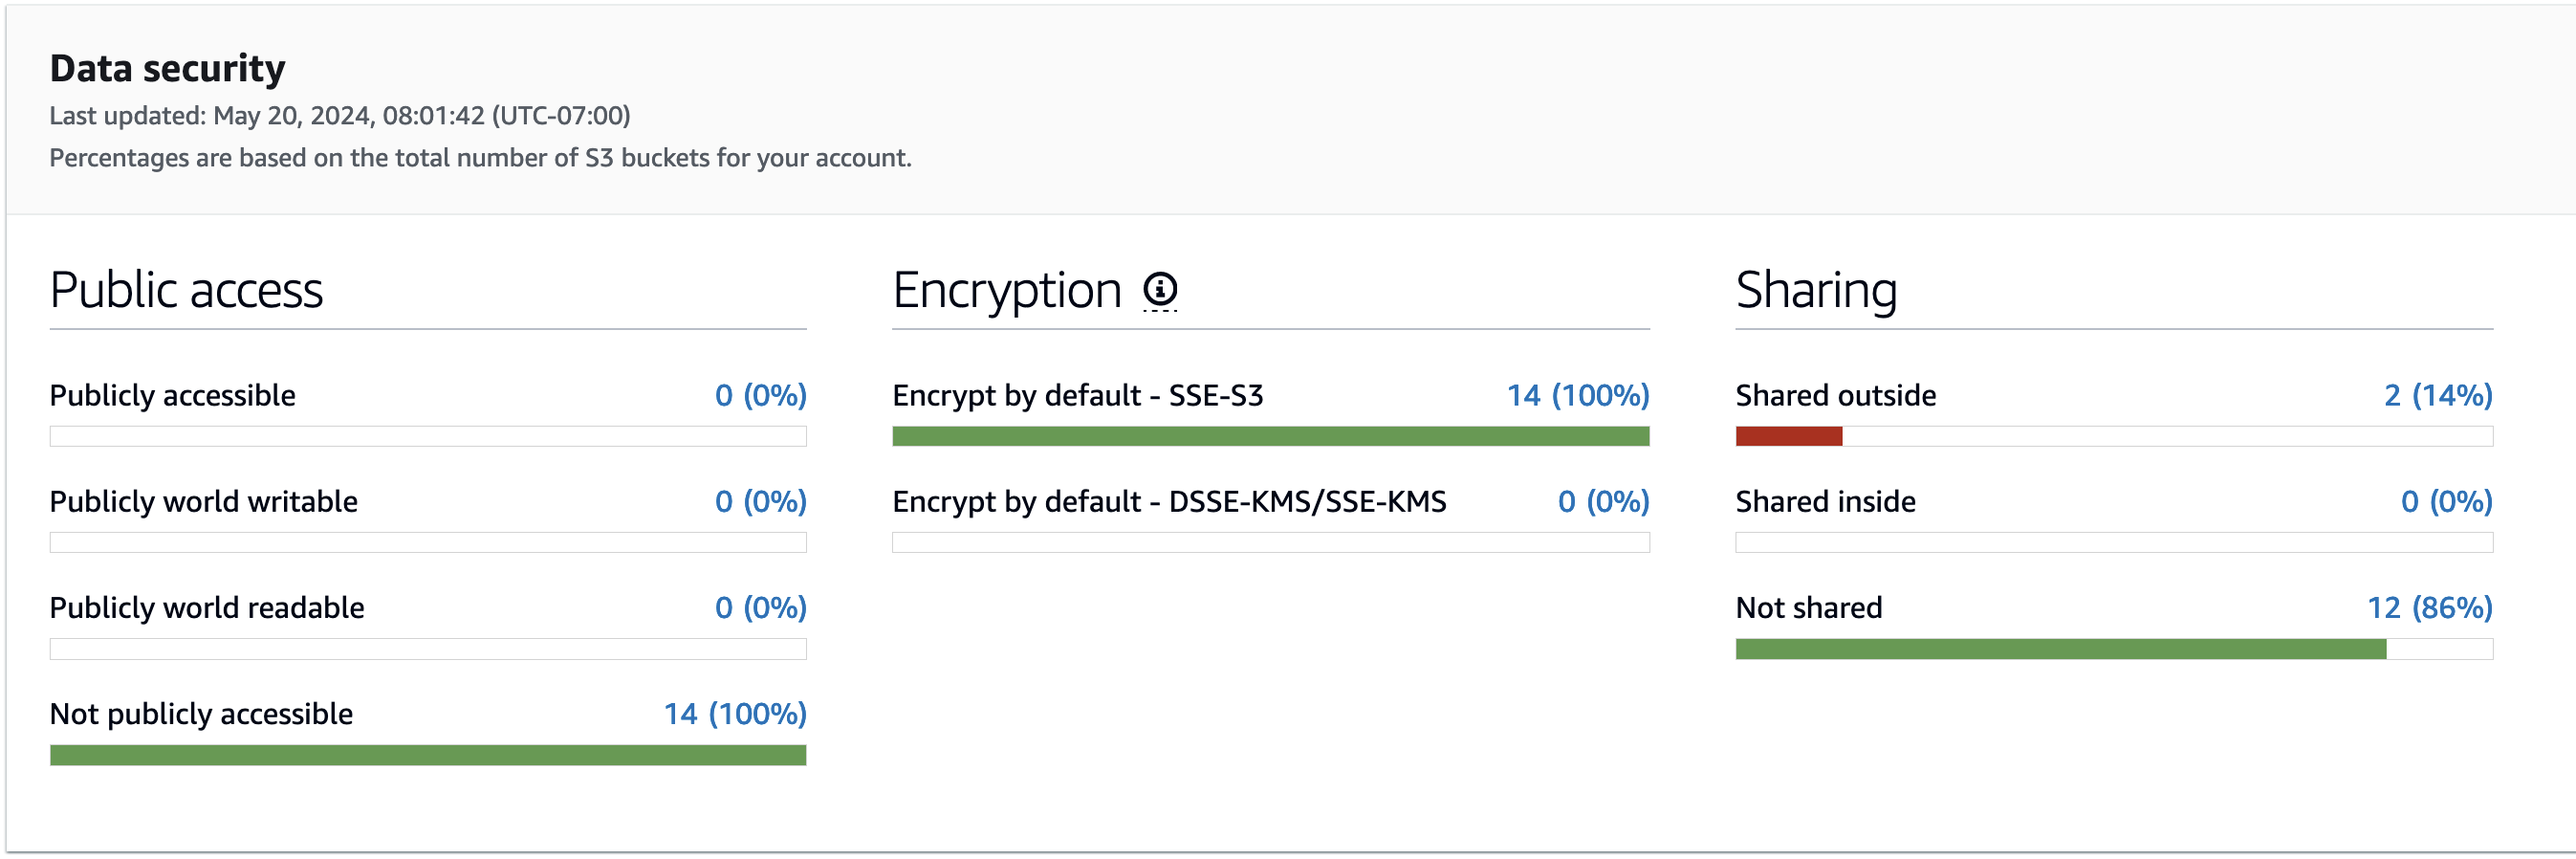
      macie-dashboard.png
  • ใช้ค้นหาข้อมูลที่ละเอียดอ่อน:
    • ขอบเขต: Bucket S3: Object, คำนำหน้า, วันที่แก้ไขล่าสุด, นามสกุล File, ขนาด Object, ฯลฯ
    • กำหนดการ: ตามความต้องการ: ครั้งเดียว / เป็นประจำ
    • ข้อมูลที่ละเอียดอ่อน: ระบุข้อมูล > กรองเฉพาะสิ่งที่จำเป็น
    • นโยบายการตรวจสอบ: การเข้าถึงสาธารณะ, ไม่เข้ารหัส
  • Dashboard:
    • ขอบเขต: Bucket/Object S3
    • ตัวระบุข้อมูล
    • ระดับความรุนแรง: วิกฤต, สูง, ปานกลาง, ต่ำ
    • Timestamp, ความถี่, นโยบาย, บัญชี, ภูมิภาค ฯลฯ

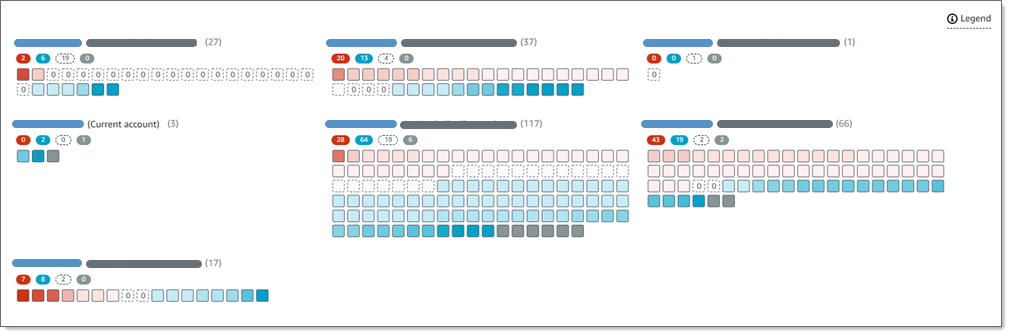
      scrn-s3-map-small.png

  • การตรวจจับและการตอบสนอง:
    S3 < Macie ตรวจจับ> EventBridge กรอง >
    • SNS แจ้งเตือนปลายทางที่สมัครรับข้อมูล
    • Lambda แก้ไขอัตโนมัติ / ตอบสนองแบบกำหนดเอง
  • มาตรฐานการปฏิบัติตามข้อกำหนดของ Macie
    มาตรฐานข้อมูลที่เกี่ยวข้อง
    PCI DSSบัตร Credit
    GDPRข้อมูลส่วนบุคคลของผู้พำนักในสหภาพ Europe
    CCPA / CPRAข้อมูลส่วนบุคคลของผู้พำนักใน Canada
    HIPAAข้อมูลสุขภาพที่ได้รับการคุ้มครอง - PHI
    • PCI DSS (มาตรฐานความปลอดภัยข้อมูลอุตสาหกรรมบัตรชำระเงิน) เป็นชุดมาตรฐานความปลอดภัยที่ครอบคลุม ออกแบบมาเพื่อปกป้องข้อมูลผู้ถือบัตร (CHD) และข้อมูลการตรวจสอบสิทธิ์ที่ละเอียดอ่อน (SAD)
    • ข้อกำหนดหลักของ PCI DSS v3.2.1 / v4.0 (ภาพรวม):
      • ติดตั้งและบำรุงรักษาการควบคุมความปลอดภัยเครือข่าย (รวมถึง Firewall)
      • ปกป้องข้อมูลผู้ถือบัตรที่จัดเก็บไว้
      • เข้ารหัสการส่งข้อมูลผู้ถือบัตรผ่านเครือข่ายสาธารณะ
      • ปกป้องระบบจาก Malware
      • พัฒนาและบำรุงรักษาระบบและ App ที่ปลอดภัย
      • จำกัดการเข้าถึงข้อมูลผู้ถือบัตรตามความจำเป็นทางธุรกิจ
      • ระบุและตรวจสอบสิทธิ์การเข้าถึงส่วนประกอบของระบบ
      • จำกัดการเข้าถึงข้อมูลผู้ถือบัตรทางกายภาพ
      • ติดตามและตรวจสอบการเข้าถึงทรัพยากรเครือข่ายและข้อมูลผู้ถือบัตรทั้งหมด
Amazon GuardDuty:
  • บริการตรวจจับภัยคุกคามอัจฉริยะที่ช่วยปกป้องบัญชี AWS, Workload และข้อมูลที่จัดเก็บใน S3
  • ตรวจสอบกิจกรรมที่เป็นอันตรายและพฤติกรรมที่ไม่ได้รับอนุญาต
  • จัดการอย่างเต็มรูปแบบ: ไม่ต้องใช้ Agent ดึงข้อมูลจาก CloudTrail, VPC Flow Log, DNS Log
  • บริการกรองภัยคุกคามข้อมูล:
    ข้อมูลที่ยังไม่ผ่านการประมวลผล เช่น เกิดอะไรขึ้น, ที่ไหน, เมื่อไหร่
    ข้อมูลเชิงลึกจากข้อมูล > ทำไมจึงเกิดเหตุการณ์นี้ขึ้น? มันบ่งบอกอะไร? ควรดำเนินการอย่างไร?
  • แหล่งข้อมูลหลัก:
    • การเรียก API (CloudTrail): Timestamp, บัญชี, แหล่งที่มาของเหตุการณ์, Resource
    • VPC Flow Log: Address ต้นทาง (srcaddr), ปลายทาง (dstaddr), Port ต้นทาง (srcport), ปลายทาง (dstport), Protocol
    • DNS Log: Query, ประเภทการ Query, Code ตอบกลับ, ประเภท Record
  • เช่น การขุด Cryptocurrency
    • CryptoCurrency:EC2/BitcoinTool.B!DNS:
    • CryptoCurrency:EC2/BitcoinTool.B:
    • UnauthorizedAccess:EC2/SSHBruteForce:
    • Recon:EC2/PortProbeUnprotectedPort:
    • Backdoor:EC2/XORDDOS:
  • การป้องกัน EKS:
    • EKS Control Plane Log (Audit Log ของ Kubernetes)
    • Runtime ของ Workload Kubernetes
  • การป้องกัน S3: เหตุการณ์ข้อมูล S3 ของ CloudTrail (GetObject, PutObject, DeleteObject เป็นต้น)
:cool:
 
Last edited:

PlAwAnSaI

Administrator
  • การ Monitor Runtime:
    • Workload EC2 และ Container (EKS, ECS บน EC2/Fargate)
    • Activity ระดับ Host
  • การป้องกัน Malware: Snapshot Volume EBS และ Scan หา Malware
  • การป้องกัน RDS: ตรวจจับ Activity การเข้าสู่ระบบที่ถูกบุกรุกสำหรับ RDS (Aurora)
  • การ Monitor Lambda: Log Activity เครือข่ายสำหรับ Function Lambda
  • ประเภทการค้นหาของ GuardDuty:
    รายการคำอธิบาย
    ประเภทการค้นหาตัวระบุภัยคุกคามที่ตรวจพบ
    เช่น UnauthorizedAccess:EC2/SSHBruteForce
    ระดับความรุนแรงสูง: 7.0 - 8.9
    ปานกลาง: 4.0 - 6.9
    ต่ำ: 0.1 - 3.9
    Resourceประเภท Resource, ARN, เป็นต้น
    การกระทำActivity ที่ตรวจพบ
    เช่น AWS_API_CALL
    ผู้กระทำIP Address, ตำแหน่งที่ตั้ง, ISP, User IAM, เป็นต้น
    Timestamp
    บัญชี

  • Digital Forensic คืออะไร?:
    • การรวบรวม การเก็บรักษา และการวิเคราะห์ข้อมูล Electronic จากอุปกรณ์ Digital
    • เพื่อเหตุผลทางกฎหมาย หรือเพื่อค้นหาสาเหตุและทำความเข้าใจผลกระทบของเหตุการณ์ด้านความปลอดภัย
    • https://monsterconnect.co.th/cyber-incident-response
      ตัวอย่าง:
    • การเตรียมการ: ตั้งค่าเครื่องมือรักษาความปลอดภัย
    • การตรวจจับ: GuardDuty, Security Hub, CloudWatch Alarms, เป็นต้น
    • การวิเคราะห์: วิเคราะห์ Log ต่างๆ
    • การควบคุม: แยก Instance EC2 ออกจากระบบ, กำหนดค่า Security Group
    • การกำจัดและการกู้คืน: เปิดใช้งาน Instance ใหม่
    • Activity หลังเกิดเหตุ: ตรวจสอบเหตุการณ์, ปรับปรุงการตั้งค่าความปลอดภัย
Amazon Inspector:
  • ระบบจะจัดการช่องโหว่โดยอัตโนมัติและตรวจจับการเปิดเผยเครือข่ายที่ไม่พึงประสงค์
  • Scan CVE, มาตรฐาน CIS, Package ระบบปฏิบัติการ, และระดับ Code
  • Scan Instance EC2, Image Container ของ ECR และ Function Lambda
  • ประเภทของการ Scan:
    การ Scan ช่องโหว่อัตโนมัติการ Scan CIS
    เกณฑ์เป้าหมาย- CVE
    - การเปิดเผยเครือข่าย
    เกณฑ์มาตรฐาน CIS
    รายการที่ Scan- Package ระบบปฏิบัติการ
    - Library ภาษา
    - การเปิดเผยเครือข่าย
    การกำหนดค่าระบบปฏิบัติการ
    ResourceEC2, ECR, LambdaEC2

  • CVSS (Common Vulnerability Scoring System) คืออะไร?:
    • เป็นกรอบมาตรฐานอุตสาหกรรมสำหรับการประเมินความรุนแรงทาง Technique ของช่องโหว่ของระบบสารสนเทศ และแสดงผล
    • บริหารจัดการโดย FIRST (Forum of Incident Response and Security Teams)
      66a555dd47f943e6344f2bc5_6442701889bf511b7beff13f_CVSS%2520Score%2520Metrics.jpeg
    • NVD (National Vulnerability Database) คือคลังข้อมูลช่องโหว่ของรัฐบาลสหรัฐฯ ดูแลโดย NIST (National Institute of Standards and Technology)
    • CVE (Common Vulnerabilities and Exposures)
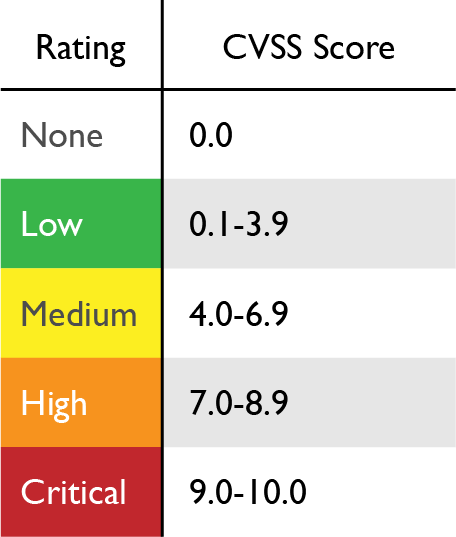
    • คะแนนพื้นฐาน CVSS และระดับความรุนแรง:
      0.0 > Informational
      cvssrating

      .
  • CIS Benchmarks คืออะไร?:
  • Template การประเมิน:
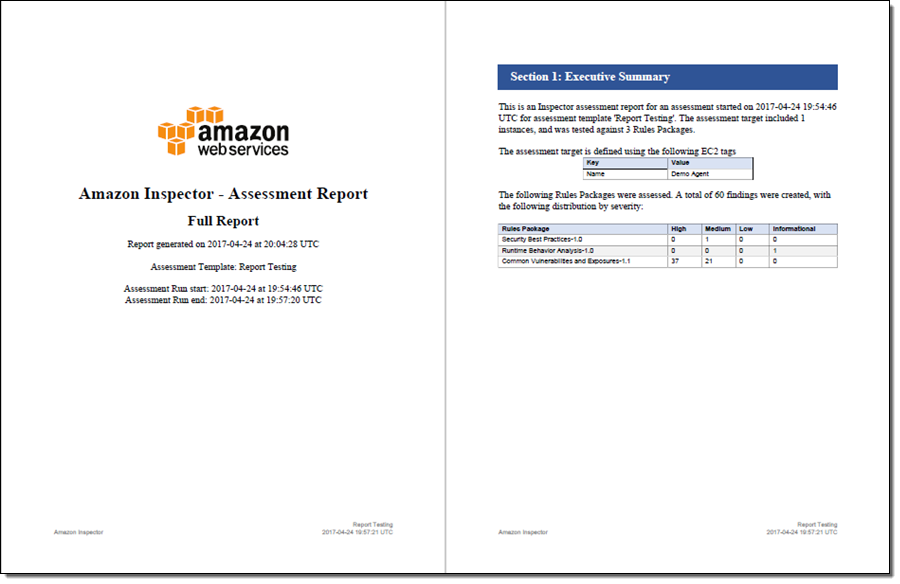
    • เป้าหมายการประเมิน - Resource ที่ Amazon Inspector ประเมิน
    • ชุดกฎ - ชุดการตรวจสอบการประเมินที่กำหนดไว้ล่วงหน้า
    • ตารางการประเมิน

      insp_full_report_cover_2.png
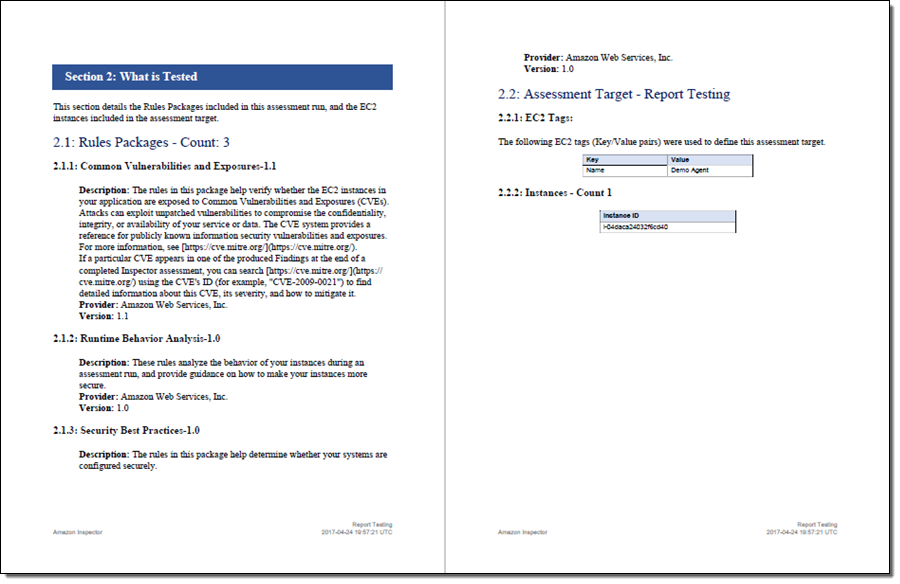
      insp_full_report_tested_2.png
    • ชุดกฎ
      • การเข้าถึงเครือข่าย - ประเมินการเข้าถึงเครือข่ายของ Resource เป้าหมาย
      • การประเมิน Host:
        • ตรวจสอบช่องโหว่ภายใน Instance EC2
        • ติดตั้ง Amazon Inspector Agent
          กฎคำอธิบาย
          ความปลอดภัยของระบบปฏิบัติการ CIS
          เกณฑ์มาตรฐานการกำหนดค่า - 1.0
          มาตรฐานการกำหนดค่าระบบอย่างปลอดภัย
          การวิเคราะห์พฤติกรรมขณะทำงาน - 1.0เกณฑ์มาตรฐานสำหรับการกำหนดค่าระบบปฏิบัติการ
          ช่องโหว่และความเสี่ยงทั่วไป - 1.1การประเมินตาม CVE
          แนวปฏิบัติที่ดีที่สุดด้านความปลอดภัย - 1.0แนวปฏิบัติที่ดีที่สุดที่ AWS จัดให้
  • EC2:
    การสแกนช่องโหว่ Software
    (การ Scan CVE)
    - Package ระบบปฏิบัติการ
    - Library ภาษา (Library Python, Java, Node.js)
    - Agent SSM
    การเข้าถึงเครือข่าย- การกำหนดค่า VPC (Security Group, ACL, Route Table, IGW, VPC Endpoint, ฯลฯ)
    - สามารถเข้าถึงได้จากเครือข่ายที่ไม่ต้องการ
    - แบบไม่ใช้ Agent
    การ Scan มาตรฐาน CIS- ระบบปฏิบัติการเป็นไปตามมาตรฐาน CIS
    - SSM Agent SSM Association

  • ECR:
    • วัตถุประสงค์: ประเมินช่องโหว่ของ Software ใน Package ระบบปฏิบัติการ และ Library ภายใน Image Container ใน ECR
    • คุณสมบัติ:
      • ไม่ต้องใช้ Agent - วิเคราะห์ Layer Image ใน ECR โดยตรง
      • Scan เมื่อมีการ Push Image ใหม่ไปยัง Repo
      • การ Scan ขั้นสูง (Enhanced) - Scan อย่างต่อเนื่อง
        .
  • Lambda:
    • วัตถุประสงค์: ตรวจจับ CVE ใน Code ที่ Function Lambda พึ่งพา (Library, Package ใน Package การ Deploy หรือ Layer Lambda)
    • คุณสมบัติ:
      • ไม่ต้องใช้ Agent
      • การ Scan จะทำงานเมื่อมีการ Deploy หรือ Update Function Lambda
      • ตรวจสอบอย่างต่อเนื่อง
    • ประเภทของการ Scan:
      • การ Scan มาตรฐาน - ตรวจสอบ Dependency และปัญหาด้านความปลอดภัย
      • การ Scan Code Lambda
        .
  • การตรวจจับและการตอบสนอง:
    • ทำให้กระบวนการตั้งแต่การตรวจจับช่องโหว่ไปจนถึงการตอบสนองเป็นไปโดยอัตโนมัติ
    • การ Integrate Amazon Inspector กับ Systems Manager
AWS Security Hub:
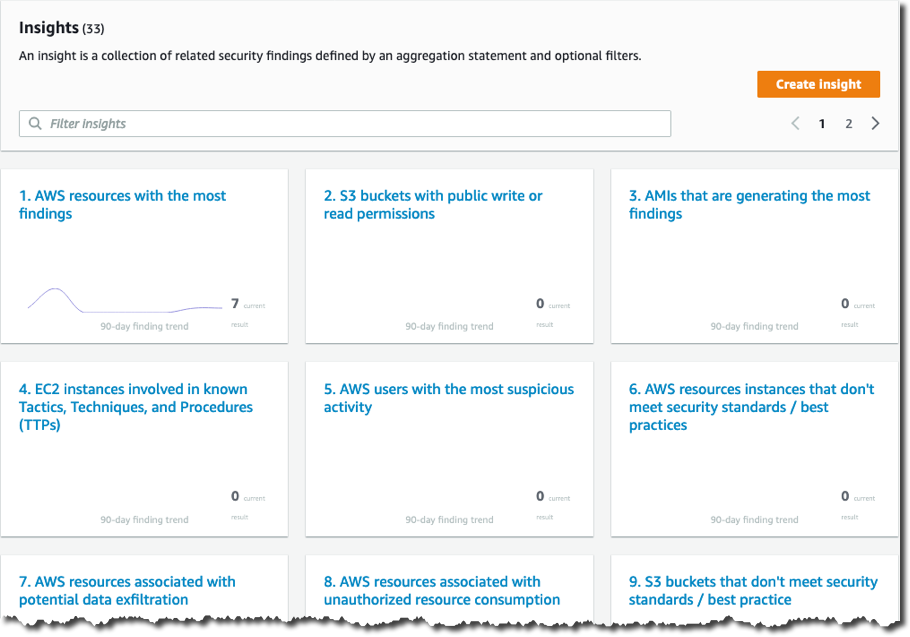
  • ภาพรวมที่ครอบคลุมสถานะความปลอดภัยทั่วทั้ง Resource AWS
  • รวบรวมข้อมูลด้านความปลอดภัยจากบริการ AWS ต่างๆ และผลิตภัณฑ์ของบุคคลที่สาม
  • AWS Security Finding Format (ASFF) คือ:
    • รูปแบบ JSON มาตรฐาน
    • รับและประมวลผลข้อมูลการค้นพบจากแหล่งต่างๆ ได้อย่างสม่ำเสมอ
  • [ขั้นตอนการตั้งค่า Security Hub]
    1. เปิดใช้งาน AWS Config
    2. เปิดใช้งาน Security Hub
    3. กำหนดค่า Security Hub:
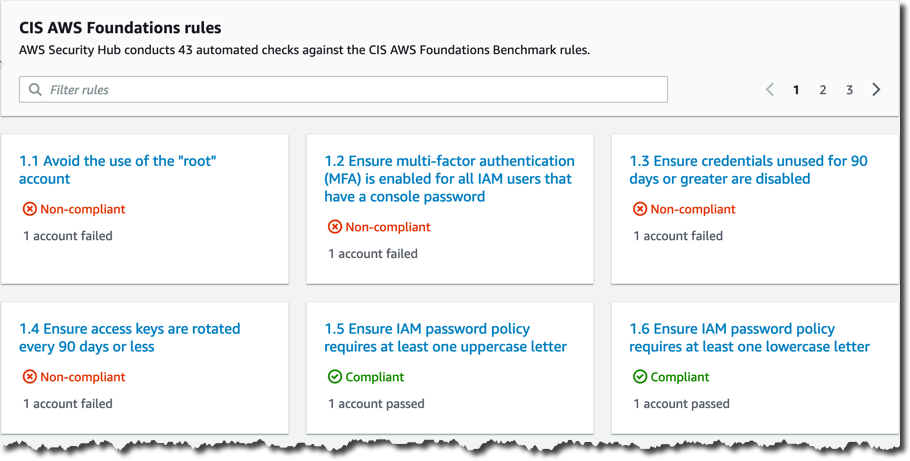
      • Best Practice ด้านความปลอดภัยของ AWS
      • มาตรฐาน CIS AWS Foundations Benchmark
      • PCI DSS
    4. (ตัวเลือก) หลายภูมิภาค
    5. (ตัวเลือก) หลายบัญชี:
      • Integrate กับ AWS Organizations (แนะนำ)
      • Invite บัญชีแต่ละบัญชีด้วยตนเอง

        2019-06-13_09-15-25-1.png
        2019-06-13_15-06-29-1.png

        .
  • CNAPP เป็นแนวคิดสำหรับการรักษาความปลอดภัยในการดำเนินงาน Public Cloud

    ผลิตภัณฑ์คำอธิบาย
    CNAPP
    (Cloud Native Application Protection Platform)
    แนวคิดแบบบูรณาการสำหรับการปกป้อง App และข้อมูลใน Public Cloud
    CSPM
    (Cloud Security Posture Management)
    ช่วยป้องกันการตั้งค่า Cloud ที่ไม่ถูกต้อง และประเมินการปฏิบัติตามข้อกำหนด
    CWPP
    (Cloud Workload Protection Platforms)
    ตรวจสอบ และปกป้อง Workload Cloud ต่างๆ

Amazon Detective:
  • ตรวจสอบสาเหตุที่แท้จริงของปัญหาด้านความปลอดภัย หรือกิจกรรมที่น่าสงสัย
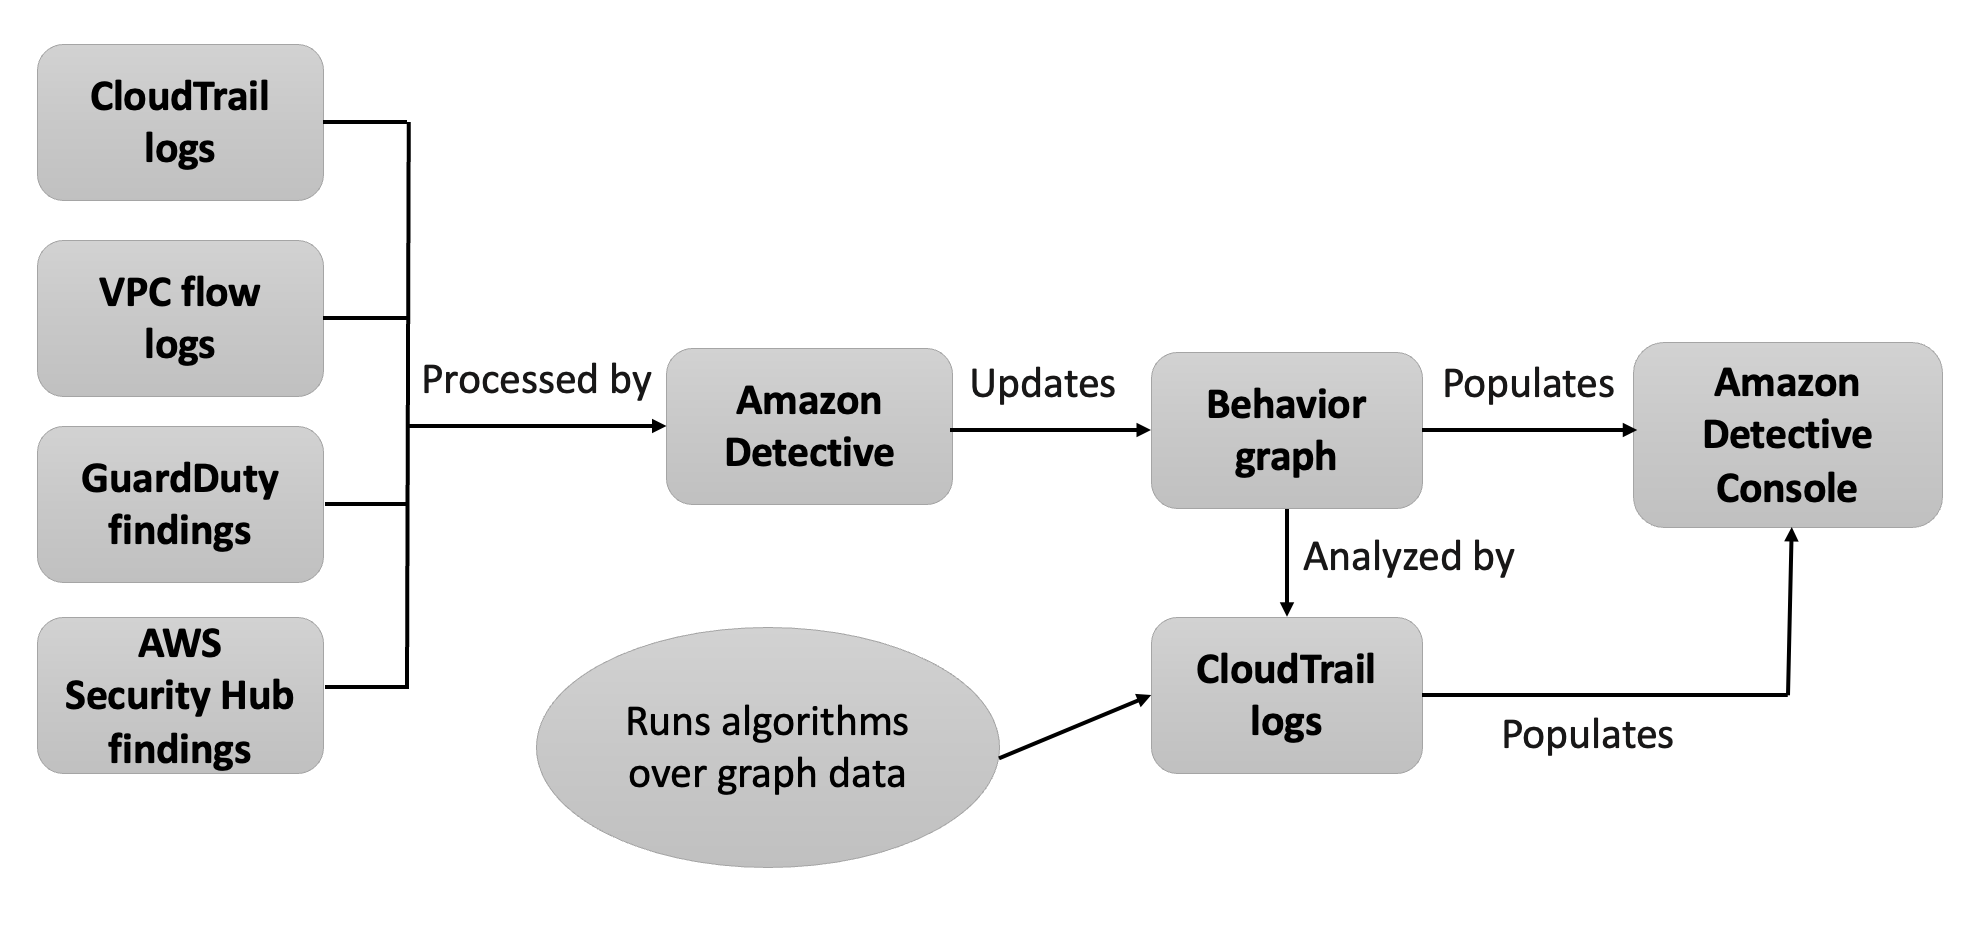
  • นำผลการค้นพบ และตรวจสอบกิจกรรมโดยการรวบรวมข้อมูล Log
  • Graph พฤติกรรม:
    • แสดงการเชื่อมต่อ และการโต้ตอบระหว่าง Resource AWS ของคุณอย่างเห็นได้ชัด
    • Instance EC2, ผู้ใช้/บทบาท IAM, ถัง S3, และ IP Address เป็นต้น
      diagram_graph_ingest_analytics.png

      diagram_graph_structure_overview.png
:cool:
 
Last edited:

PlAwAnSaI

Administrator
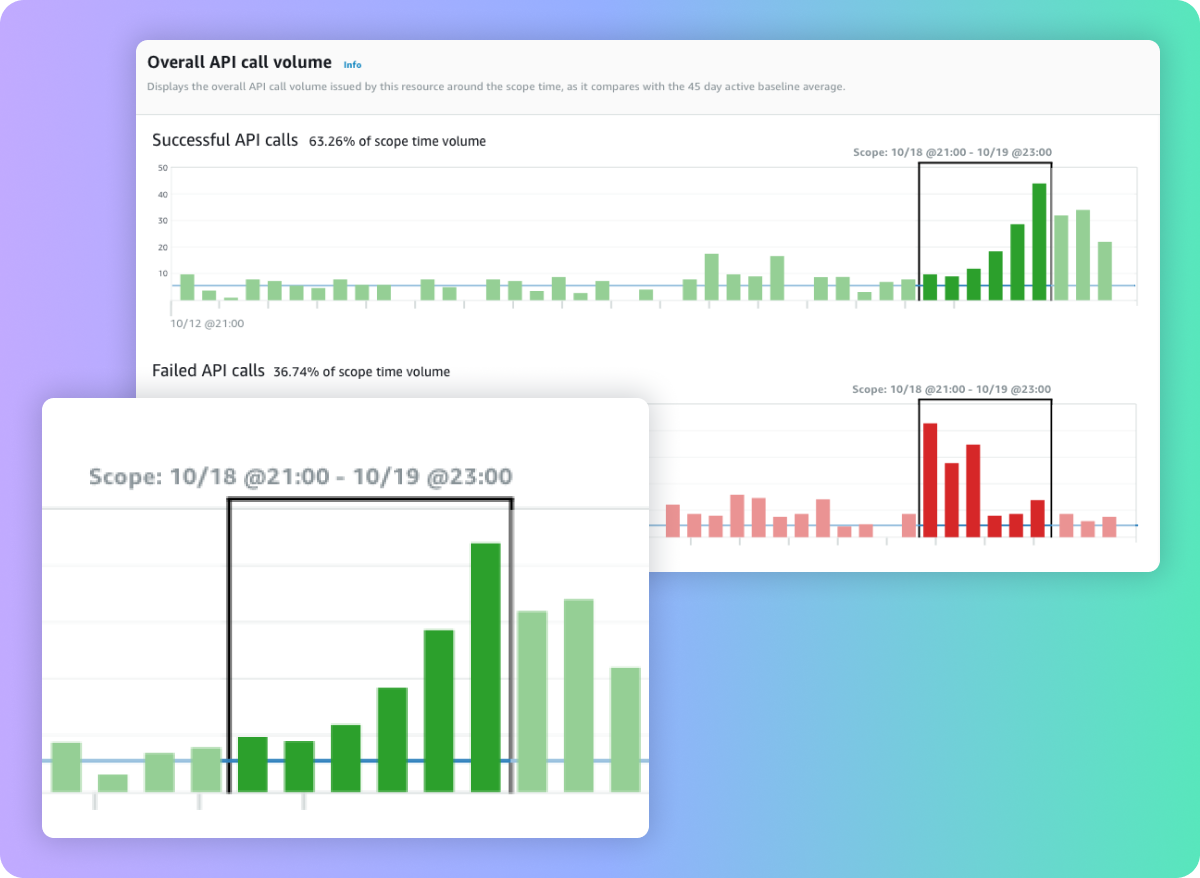
  • การเรียกใช้ API เพิ่มขึ้นอย่างผิดปกติ

    30f964eb22715f554943c8f36d5b9554.8ee37d6f439a3a3c32c6f1385e3062729b956964.png
  1. การตรวจสอบ: เลือกการค้นพบ
  2. ผลการวิเคราะห์:
    • สามเหลี่ยม: การค้นหาประเภท, ความรุนแรง, และอื่นๆ
    • เข้าใจเหตุการณ์ หรือการโจมตีด้านความปลอดภัยที่อาจเกิดขึ้น
  3. การวิเคราะห์ใน Entity
  4. การตรวจสอบอย่างต่อเนื่อง
    • รายละเอียดของ Entity ที่ใช้หน้า Profile
    • ตรวจสอบด้วย Log:
      • การเรียกใช้ API (CloudTrail)
      • เครือข่าย (VPC Flow Log)
      • แหล่งอื่น ๆ
    • > กิจกรรมผิดปกติ :devilish:
      .
  • Key ที่ AWS KMS สร้างให้สามารถใช้ Automatic Key Rotation ได้ ส่วน Key ที่ใช้ Imported Key Material ต้อง Rotate แบบ Manual ด้วยการสร้าง Key ใหม่ และย้าย Alias ไปยัง Key ใหม่

  • Session Manager สามารถเชื่อมต่อเข้า EC2 ได้ผ่าน SSM Agent โดยไม่ต้องเปิด Port 22 (SSH) และไม่ต้องมี Bastion Host และสามารถเปิดการเก็บ Session Log ไปยัง Amazon S3 และ Amazon CloudWatch Logs เพื่อให้สามารถตรวจสอบคำสั่ง และกิจกรรมที่เกิดขึ้นในแต่ละ Session ได้อย่างละเอียด
    CloudTrail บันทึกได้แค่ว่าใครเริ่ม Session เมื่อไร แต่ไม่สามารถบันทึก Command ที่ Run ภายใน Session ได้

  • เวลาทำ Security Hub แบบ Multi-Account ให้เปิด Security Hub ที่บัญชีกลางก่อนถึงจะ → ตั้งเป็น Admin ได้ → เปิด Security Services ที่ Member → ให้ Admin Assume Role เข้าไปจัดการได้

  • EC2 ↔ EC2 ภายใน VPC ✅ VPC Flow Logs จะบันทึกข้อมูล Network Traffic ที่เข้าออก ENI (Elastic Network Interface) ของ EC2
    DNS Queries / DNS Tunneling / Covert Channel ✅ Route 53 Resolver Logs จะเก็บข้อมูล DNS Query ทั้งหมดที่ออกจาก VPC จะเห็นพฤติกรรม
    Traffic ผ่าน Transit Gateway ✅ Transit Gateway Flow Logs จะบันทึก Traffic ที่วิ่งผ่าน TG ระหว่างหลาย VPC, VPN หรือ Direct Connect

Data Engineer:

  • วิศวกรข้อมูล (Data Engineer) จะสร้างระบบที่ทำหน้าที่ส่งมอบข้อมูลที่ผ่านการประมวลผล และคัดสรรมาแล้วให้กับนักวิเคราะห์ข้อมูล (Data Analyst) ในระหว่างกระบวนการสำรวจ และทำความเข้าใจข้อมูล (Data Discovery) วิศวกรข้อมูลสามารถรวบรวมความต้องการจากนักวิเคราะห์ข้อมูล เพื่อให้ระบบสามารถส่งมอบข้อมูลที่นำไปใช้งานได้จริงและตรงตามความต้องการ
    หรือ Data Engineer จะคุยกับ Data Analyst ตั้งแต่ต้นว่า "ต้องการข้อมูลแบบไหน ใช้วิเคราะห์อะไร" แล้วจึงออกแบบระบบและเตรียมข้อมูลให้พร้อมใช้งาน ไม่ใช่แค่ดึงข้อมูลดิบมาให้เฉย ๆ

  • Data Engineer → สร้าง และดูแลโครงสร้างพื้นฐานด้านข้อมูล (Data Platform), จัดการ Dataset, ดูแล Security และ Compliance > เตรียมถนน และวางระบบ
    Data Analyst → วิเคราะห์ข้อมูล สร้าง Dashboard และนำเสนอข้อมูลเพื่อช่วยตัดสินใจ > อ่านแผนที่ และอธิบายข้อมูล
    Data Scientist → วิเคราะห์เชิงลึก สร้างและฝึกสอน Model Machine Learning (ML) เพื่อคาดการณ์หรือแก้ปัญหาทางธุรกิจ > สร้าง Model อัจฉริยะจากข้อมูล

  • Data Discovery = การทำความรู้จักข้อมูลก่อนลงมือใช้งานจริง ขั้นตอนหลัก ๆ ได้แก่:
    🔍 หาแหล่งข้อมูล (Identify Data Source) เช่น ข้อมูลจาก Database, API, Log, Excel หรือระบบต่าง ๆ
    👥 ระบุผู้เกี่ยวข้อง (Stakeholder) เช่น Business User, Data Analyst, Data Engineer หรือ Team อื่นที่ใช้ข้อมูล
    📊 ทำความเข้าใจข้อมูล (Understand Data) ข้อมูลมีความหมายอะไร คุณภาพเป็นอย่างไร มีข้อจำกัดหรือไม่
    💡 หาวิธีสร้างคุณค่าจากข้อมูล (Define Use Case) เช่น ทำ Dashboard, วิเคราะห์พฤติกรรมลูกค้า หรือสร้าง Model ML

  • Data Discovery = "เข้าใจข้อมูลและความต้องการให้ครบก่อน แล้วค่อยออกแบบและสร้างระบบจริง" สิ่งที่อยู่ใน Data Discovery ✅:
    • มีแหล่งข้อมูลอะไรบ้าง (What data exists?)
    • ข้อมูลอยู่ที่ไหน เข้าถึงได้อย่างไร
    • ต้องแปลงข้อมูลอย่างไร (Transformation)
    • ใครเป็นผู้เกี่ยวข้อง (Stakeholder)
    • ข้อมูลสามารถสร้างคุณค่าอะไรได้บ้าง (Use Case)
    • เก็บความต้องการทางธุรกิจต้องการใช้ข้อมูลเพื่ออะไร? และการวิเคราะห์
    • ข้อมูลมีรูปแบบอะไร? (CSV, JSON, Database, Logs ฯลฯ)
    • ปริมาณข้อมูลมากน้อยแค่ไหน? (GB, TB, Streaming หรือ Batch)
    • ต้องประมวลผลข้อมูลระดับไหน? (Real-time หรือ Batch)
    • จะสร้างคุณค่าจากข้อมูลได้อย่างไร?
      .
  • Data Silos = ข้อมูลถูกขังอยู่ในแต่ละแผนก ตัวอย่างเช่น:
    🛒 ฝ่ายขาย (Sales) มีฐานข้อมูลลูกค้าของตัวเอง
    📢 การตลาด (Marketing) มีข้อมูล Campaign ของตัวเอง
    🎧 ฝ่ายบริการลูกค้า (Support) มีข้อมูลการร้องเรียนของตัวเอง
    แต่ละฝ่ายเก็บข้อมูลแยกกัน และระบบไม่สามารถเชื่อมต่อ หรือแลกเปลี่ยนข้อมูลกันได้

  • หลังส่งมอบข้อมูลแล้ว ผู้ใช้อาจต้องการ เพิ่มข้อมูลใหม่ / ปรับ Logic การคำนวณ / เปลี่ยน Dashboard / ปรับปรุงคุณภาพข้อมูล
    จึงต้องย้อนกลับไปทำบางขั้นตอนอีกครั้ง จึงต้องมีวงจร (Iterative)
    📝 "เอาเข้า → เก็บ → จัดหมวด → ประมวลผล → ส่งมอบ"
    หรือ Ingest → Store → Catalog → Process → Deliver

  • Data Catalog = สารบัญข้อมูลขององค์กร เปรียบเหมือนกับ "Google Maps ของข้อมูล" หรือ "ห้องสมุดที่มีระบบค้นหาหนังสือ"
    แทนที่จะต้องถามว่า "ข้อมูลลูกค้าอยู่ที่ไหนนะ?" / "ตารางนี้ใครเป็นเจ้าของ?" / "ข้อมูลชุดนี้เชื่อถือได้หรือเปล่า?"
    เราสามารถเปิด Data Catalog แล้วค้นหาได้ทันที
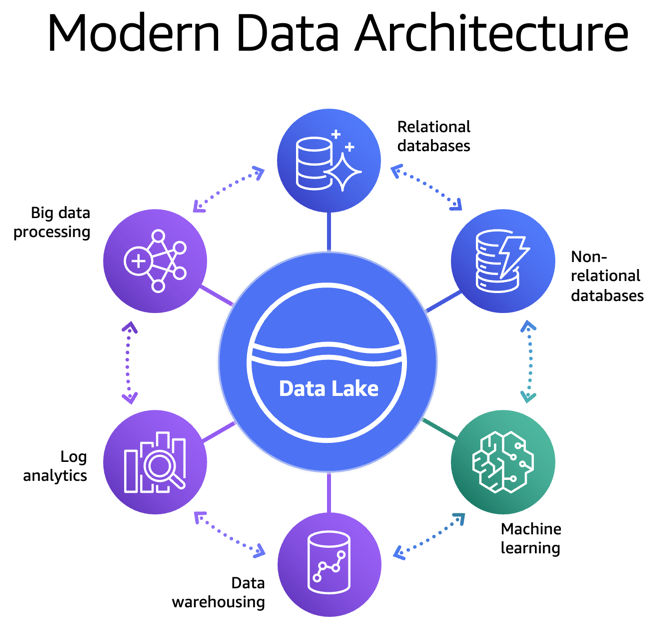
modern-data-architecture-reference-architecture.png

This-diagram-demonstrates-the-pattern-for-sharing-data-catalogs-between-producer-domains-and-consumer-domains.png

modern-data-architecture.png


chatgpt.com/share/6a69b913-6cc8-83ec-a53e-dab5a61b6901
Code:
https://www.credly.com/org/amazon-web-services/badge/aws-knowledge-cloud-essentials-training-badge
  • ผู้ดูแลระบบ (System Administrator) ต้องมีความเชี่ยวชาญในการจัดการการกำหนดค่าของระบบ (Configuration Management) และการจัดการการเปลี่ยนแปลง (Change Management)

  • ผู้ดูแลระบบ (Administrator) ด้าน DevOps ต้องมีความเชี่ยวชาญในการเขียน Program และการใช้ภาษา Script เพื่อพัฒนา และทำงานอัตโนมัติ (Automation) และยังทำหน้าที่ดูแล Team ฐานข้อมูล (Database) และ Team พัฒนา (Developer)

  • Cloud Architect เป็นผู้เชี่ยวชาญด้าน AWS Cloud ประจำองค์กร ซึ่งมีหน้าที่ให้คำแนะนำ ออกแบบสถาปัตยกรรม และเป็นผู้ให้คำปรึกษาด้าน Technique เกี่ยวกับ AWS

  • บทบาทของ IT Solutions Architect ในระบบ On-premises เทียบได้กับบทบาท AWS Cloud Architect ใน Cloud Environment

  • ลูกค้าเดินไปที่ Barista และสั่งกาแฟ Barista จัดเตรียมกาแฟ และส่งกลับให้ลูกค้า ตัวอย่างนี้อธิบายรูปแบบการทำงานของ Client-Server คือ Model ที่ Client ส่งคำร้องขอ (Request) ไปยัง Server จากนั้น Server จะประมวลผลคำร้องขอเหล่านั้นและส่งผลลัพธ์ที่เหมาะสมกลับมา (Response) โดย Server จะไม่ทำงานเองหากไม่ได้รับคำขอจาก Client ส่วน Cloud Computing จะให้บริการทรัพยากรของ Server ที่สามารถปรับขนาด (Scalable) และมีความยืดหยุ่น (Flexible) ซึ่งสามารถเข้าถึงได้ผ่านทาง Internet

  • ด้วย Solution Hybrid Cloud สามารถเก็บข้อมูลที่มีความละเอียดอ่อน (Sensitive Data) ไว้บนระบบ On-premises เพื่อให้เป็นไปตามข้อกำหนดด้าน Compliance ในขณะที่ใช้ทรัพยากรบน Cloud สำหรับการขยายระบบแบบยืดหยุ่น (Dynamic Scaling)

  • ด้วย AWS Cloud บริษัทสามารถปรับขนาดทรัพยากร (Scale Resource) เพิ่มขึ้น หรือลดลงได้อย่างสะดวกตามความต้องการใช้งานจริง ทำให้ไม่จำเป็นต้องคาดเดาความต้องการด้าน Capacity ในอนาคต

  • ใน AWS Shared Responsibility Model ลูกค้าเป็นผู้รับผิดชอบในการจัดการ OS Patch โดย AWS จะเป็นผู้จัดเตรียม Infrastructure พื้นฐาน แต่ลูกค้าต้องตรวจสอบให้แน่ใจว่าระบบปฏิบัติการ (OS) ของตนได้รับการ Update ด้วย Security Patch ล่าสุดอยู่เสมอ

    ลูกค้ายังเป็นผู้รับผิดชอบในการเข้ารหัส (Encryption) ข้อมูลฝั่ง Client-side ด้วย โดย AWS มีบริการต่าง ๆ ที่ช่วยสนับสนุนด้านการเข้ารหัส แต่ลูกค้าเป็นผู้รับผิดชอบในการนำบริการเหล่านั้นไปใช้งาน และบริหารจัดการ

    ในขณะที่AWS เป็นผู้รับผิดชอบด้านความปลอดภัยทางกายภาพ (Physical Security) ของ Data Center ซึ่งรวมถึงมาตรการต่าง ๆ เช่น การควบคุมการเข้าถึง (Access Control), ระบบเฝ้าระวัง (Surveillance) และการควบคุม Environment รวมถึงการ Update Software สำหรับบริการด้าน Compute, Networking, Storage และ Database ก็เป็นความรับผิดชอบของ AWS เช่นกัน
:cool:
 
Last edited:

PlAwAnSaI

Administrator
  • AWS มีศูนย์ข้อมูล (Data Center) หลายแห่งกระจายอยู่ในภูมิภาคทางภูมิศาสตร์ (Geographic Region) ที่แตกต่างกัน การออกแบบลักษณะนี้ช่วยเพิ่มความพร้อมใช้งานของระบบ (High Availability) โดยทำให้มั่นใจได้ว่าร้านค้า Online ของคุณสามารถรองรับปริมาณ Traffic ที่เพิ่มขึ้นได้ แม้ในกรณีที่เกิดเหตุการณ์ที่ไม่คาดคิด

  • Region คือสถานที่ตั้งทางกายภาพ (Physical Location) แห่งหนึ่งบนโลกที่ประกอบด้วย Data Center หลายแห่งที่ถูกแยกออกจากกัน (Isolated Data Center) ส่วน Availability Zone (AZ) ประกอบด้วย Data Center หนึ่งแห่ง หรือหลายแห่งที่แยกเป็นอิสระต่อกัน โดยแต่ละแห่งมีระบบไฟฟ้า ระบบเครือข่าย และการเชื่อมต่อ (Connectivity) เป็นของตัวเอง

  • Cloud Computing เป็นการให้บริการทรัพยากรด้าน IT ตามความต้องการ (On-demand) ผ่านทาง Internet โดยคิดค่าบริการตามการใช้งานจริง (Pay-as-you-go Pricing) ไม่มีต้นทุนคงที่ (Fixed Costs)

  • การย้ายระบบขึ้นสู่ Cloud ช่วยให้องค์กรสามารถถ่ายโอนความรับผิดชอบในการดูแล Data Center ทางกายภาพไปยังผู้ให้บริการ Cloud ทำให้ลดภาระงานด้านการปฏิบัติการ (Operational Overhead)

  • Global Infrastructure โดยทั่วไปหมายถึงการกระจายทรัพยากรไปยัง Data Center หลายแห่งในพื้นที่ทางภูมิศาสตร์ที่แตกต่างกัน การมีระบบสำรอง (Redundant System) อยู่ในหลายตำแหน่งช่วยเพิ่มความสามารถในการทนต่อความล้มเหลว (Fault Tolerance) หากส่วนประกอบหนึ่งเกิดขัดข้อง ระบบส่วนอื่นสามารถเข้ามาทำงานแทนได้ เพื่อลด Downtime และช่วยให้ระบบมีความพร้อมใช้งานสูง (High Availability)

GCP:
  • ในการจัดการ Kubernetes ขนาดใหญ่ GKE จะใช้แนวคิดของ Fleet เพื่อรวมหลาย Cluster ให้สามารถบริหารจัดการจากศูนย์กลางได้ง่ายขึ้น โดยเมื่อมีการนำ Cluster เข้าร่วม Fleet ระบบจะติดตั้ง Connect Agent ให้อัตโนมัติเพื่อสร้างการเชื่อมต่อที่ปลอดภัยกับ Google Cloud จากนั้น Fleet จะช่วยให้องค์กรสามารถ Run และดูแล Workload ข้ามหลาย Environment หรือหลาย Cloud ได้อย่างมีประสิทธิภาพ และรองรับการขยายตัว นอกจากนี้ยังมี Policy Controller ที่ทำหน้าที่ตรวจสอบ และบังคับใช้นโยบายต่าง ๆ ผ่านการตรวจสอบ API Request เพื่อให้มั่นใจว่าการดำเนินงานเป็นไปตามข้อกำหนด และมาตรฐานที่กำหนดไว้ และในกรณีที่องค์กรเลือกใช้ผู้ให้บริการ Cloud มากกว่าหนึ่งรายเพื่อรองรับข้อกำหนดด้านความปลอดภัยหรือ Data Sovereignty แนวทางดังกล่าวจะเรียกว่า Multi-cloud Strategy

  • การใช้งาน GKE Fleet สามารถเปิดใช้งานได้ทั้งผ่านคำสั่ง gcloud ใน Cloud Shell และผ่าน Google Cloud Console โดยเมื่อมีการ Register Cluster เข้าสู่ Fleet ระบบจะติดตั้ง Connect Agent เพื่อสร้างการเชื่อมต่อที่ปลอดภัยกับ Google Cloud และเปิดให้ Connect Gateway ทำหน้าที่เป็นช่องทางเข้าถึง Cluster จากที่ใดก็ได้อย่างปลอดภัย การ Register ดังกล่าวจะทำให้ Cluster กลายเป็นส่วนหนึ่งของ Fleet ซึ่งช่วยให้องค์กรสามารถบริหารจัดการ Kubernetes Cluster ที่กระจายอยู่บน Google Cloud, AWS และ Azure ได้จากศูนย์กลางเดียว ลดความซับซ้อนในการดูแลหลาย Environment และด้วยความสามารถของ GKE ที่ทำหน้าที่เสมือนระบบปฏิบัติการสำหรับการจัดการ Kubernetes Cluster จึงช่วยให้การดูแลโครงสร้างพื้นฐาน และ Workload ขนาดใหญ่มีประสิทธิภาพมากยิ่งขึ้น

  • ในการบริหารจัดการ GKE Fleet สามารถกำหนดสิทธิ์ให้สมาชิกใน Team เข้าถึง Team Scope ได้ด้วยคำสั่ง gcloud container fleet scopes add-app-operator-binding โดย Fleet ยังรองรับการทำ Rollout Sequencing เพื่อให้ Upgrade Cluster ได้อย่างเป็นขั้นตอน และควบคุมความเสี่ยงได้ดีขึ้น นอกจากนี้ Fleet ยังช่วยลดความซับซ้อนในการบริหาร และกำกับดูแล Kubernetes Cluster จำนวนมาก ด้วยการจัดกลุ่ม Cluster แบบ Logical Grouping ภายใต้นโยบายที่สอดคล้องกัน ทำให้องค์กรสามารถบริหารหลาย Cluster ได้อย่างมีมาตรฐาน และมีประสิทธิภาพจากศูนย์กลางเดียว โดยองค์ประกอบสำคัญของ Fleet Management คือการจัดกลุ่ม Kubernetes Cluster หลายตัวเข้าด้วยกัน และการบังคับใช้นโยบายเดียวกันในทุก Cluster

  • การบริหารจัดการ Kubernetes Cluster จำนวนมากให้มีมาตรฐานเดียวกันสามารถทำได้ด้วย Config Sync ซึ่งช่วยให้การกำหนดค่ามีความสอดคล้อง ตรวจสอบย้อนหลังได้ และมีการจัดเก็บ Version อย่างเป็นระบบ การสร้าง Foundation ที่เป็นมาตรฐาน และสามารถนำกลับมาใช้ซ้ำได้ยังช่วยวางรากฐานการ Deploy แบบขับเคลื่อนด้วย Policy(-driven) อย่างมีประสิทธิภาพ เมื่อองค์กรมี Cluster กระจายอยู่หลาย Team และหลาย Project ความท้าทายสำคัญคือการรักษาความสม่ำเสมอ ความปลอดภัย และประสิทธิภาพในการจัดการ ซึ่ง GitOps เข้ามาช่วยด้วยการจัดเก็บการเปลี่ยนแปลงทั้งหมดไว้ใน Repository กลางเพื่อให้ติดตาม และควบคุมได้ง่าย ขณะที่ Policy Controller จะช่วยบังคับใช้นโยบายด้าน Security และ Compliance กับสถานะที่ต้องการของระบบ และ Config Connector ยังขยายแนวคิด GitOps จากการจัดการ Kubernetes Resource ไปสู่การบริหารทรัพยากรบน Google Cloud ได้จากรูปแบบการกำหนดค่าที่สอดคล้องกันอีกด้วย

  • การจัดการ Fleet มุ่งเน้นไปที่การบริหาร Kubernetes Cluster หลายตัวร่วมกันเป็นกลุ่มเดียวเพื่อให้ดูแลได้จากศูนย์กลาง โดยในส่วนของ Gateway จะใช้ฟิลด์ gatewayClassName ใน File YAML เพื่อระบุประเภทของ Load Balancer ขณะที่ Fleet Networking จะช่วยสร้าง Unified Network Fabric ทำให้ Cluster ต่าง ๆ สามารถสื่อสารกันได้อย่างมีประสิทธิภาพ สำหรับ MultiCluster Service จะเลือก Pod ที่ต้องการใช้งานผ่าน Label และข้อมูลของ Cluster ส่วน Multi-cluster Gateway มีหน้าที่ควบคุมการรับส่ง Traffic จากภายนอกเข้าสู่ Cluster และการเปิดใช้งาน Multi-cluster Services จำเป็นต้อง Register Cluster เข้า Fleet ก่อน นอกจากนี้ภายใน Kubernetes Cluster เอง Pod จะค้นหา และสื่อสารกันผ่านกลไก Service Discovery ซึ่งช่วยให้การเชื่อมต่อบริการต่าง ๆ เป็นไปโดยอัตโนมัติ และยืดหยุ่นมากขึ้น

  • การเริ่มใช้งาน Cloud Service Mesh (CSM) จำเป็นต้องเปิดใช้งาน Cloud Service Mesh API ก่อน จากนั้นสามารถใช้คำสั่ง istioctl kube-inject เพื่อ Inject Envoy Sidecar Proxy เข้าไปใน Workload สำหรับการทดสอบได้ โดย CSM ช่วยลดความซับซ้อนด้านการจัดการเครือข่าย ทำให้นักพัฒนาเขียน Code ได้สะอาด และเรียบง่ายขึ้น ขณะที่ Google จะเป็นผู้ดูแลเรื่องการ Upgrade การขยายระบบ และความปลอดภัยของ Platform นอกจากนี้ Dashboard ของ CSM ยังช่วยให้มองเห็น Golden Signal ด้าน Latency ได้อย่างชัดเจน และระบบยังใช้ Mutual TLS (mTLS) เพื่อเข้ารหัสการสื่อสารระหว่าง Service โดยอัตโนมัติ เมื่อ Sidecar Proxy ทำงานแล้ว จะคอยดักจับ Traffic เพิ่มการเข้ารหัสด้วย mTLS และเก็บ Telemetry Data สำหรับการติดตาม และวิเคราะห์การทำงานของระบบต่อไป

  • Cloud Service Mesh สามารถเรียนรู้โครงสร้างเครือข่าย และบริการต่าง ๆ ภายใน Kubernetes ได้โดยอัตโนมัติ ทำให้ไม่จำเป็นต้องกำหนดค่าระบบเครือข่ายด้วยตนเองทั้งหมด เมื่อต้องการทดสอบการเปลี่ยนแปลง หรือวิเคราะห์ผลกระทบของระบบ สามารถใช้ Technique Traffic Mirroring เพื่อส่งสำเนาของ Traffic จริงไปยังบริการที่ต้องการทดสอบได้ โดยการกำหนดเส้นทางการร้องขอภายใน Istio Service Mesh จะใช้ทรัพยากรประเภท VirtualService ขณะที่ Circuit Breaker จะช่วยป้องกันปัญหาจากการเชื่อมต่อที่มากเกินไป หรือบริการปลายทางที่ล้มเหลวด้วยการจำกัดจำนวนการเชื่อมต่อเมื่อถึงค่าที่กำหนด และในส่วนของการจัดการ Traffic ขาเข้า และขาออกบริเวณขอบของ Mesh จะใช้ทรัพยากรประเภท Gateway ซึ่งถูกนำไปใช้งานกับ Envoy Proxy เพื่อควบคุมการรับส่งข้อมูลระหว่างภายนอก และภายในระบบอย่างมีประสิทธิภาพ

  • ความปลอดภัยใน Service Mesh เริ่มจากการยืนยันตัวตน และกำหนดสิทธิ์ให้บริการต่าง ๆ สามารถตรวจสอบความน่าเชื่อถือซึ่งกันและกันได้ โดยการจำกัดการเข้าถึงบริการภายในเครือข่ายจะช่วยให้สามารถควบคุมการสื่อสารได้อย่างละเอียด และปลอดภัยมากยิ่งขึ้น ในกรณีที่กำหนด Peer Authentication เป็น Mode STRICT ระบบจะบังคับให้ทุกการสื่อสารใช้ mTLS (Mutual TLS) เพื่อยืนยันตัวตน และเข้ารหัสข้อมูลระหว่างบริการ นอกจากนี้การกำหนดสิทธิ์ให้บริการ และคำขอต่าง ๆ อย่างเหมาะสมยังช่วยให้แต่ละบริการเข้าถึงเฉพาะข้อมูลที่ได้รับอนุญาตเท่านั้น และการใช้ TLS (Transport Layer Security) จะช่วยปกป้องข้อมูลที่ส่งผ่านเครือข่ายระหว่าง Microservices จากการถูกดักฟัง หรือแก้ไขข้อมูลระหว่างทางได้
:cool:
 
Last edited:

PlAwAnSaI

Administrator
  • ในการเชื่อมต่อ GKE Cluster ที่อยู่คนละเครือข่ายโดยไม่ต้องใช้ VPN สามารถใช้ East-West Gateway เพื่ออำนวยความสะดวกในการสื่อสารระหว่าง Cluster ได้ โดยหากต้องการสร้าง Multi-cluster Mesh ที่กระจายอยู่หลาย Region จำเป็นต้องกำหนด Firewall Rule เพื่ออนุญาตการรับส่งข้อมูลข้าม Subnet อย่างชัดเจน สำหรับ Private Cluster ขั้นตอนแรกคือการตั้งค่า Endpoint Discovery ผ่านการสร้าง Secret ด้วยตนเองเพื่อให้แต่ละ Cluster สามารถค้นหา และสื่อสารกันได้ ในกรณีที่ใช้งาน Shared VPC การสร้าง Firewall Rule เพื่อเปิดการสื่อสารระหว่าง CIDR Range ของแต่ละ Cluster มักเป็นความรับผิดชอบของ Team Network หรือ Security ส่วนกลาง และหากเป็น Attached Cluster ที่ Run อยู่ใน Environment ของลูกค้า Cluster นั้นจะต้องถูก Register เข้ากับ GKE เพื่อให้สามารถบริหารจัดการร่วมกับระบบ Multi-cluster ได้อย่างถูกต้อง

  • การจัดการตัวตน และการยืนยันตัวตนบน Google Kubernetes Engine (GKE) มีหลายรูปแบบตามลักษณะการใช้งาน โดยกระบวนการที่ทำงานอยู่ภายใน Pod จะใช้ Kubernetes Service Account (KSA) Token สำหรับยืนยันตัวตน และเข้าถึง Kubernetes API Server ขณะที่ Workload บน GKE ที่ต้องเชื่อมต่อไปยังบริการต่าง ๆ ของ Google Cloud ควรใช้ Workload Identity เพื่อเชื่อมโยง Kubernetes Service Account เข้ากับ Google Cloud IAM อย่างปลอดภัยโดยไม่ต้องจัดการ Service Account Key เอง ส่วน Connect Gateway จะใช้ Google ID เป็นข้อมูลรับรองเริ่มต้นสำหรับการยืนยันตัวตนของผู้ใช้งาน และ GKE Identity Service รองรับการเชื่อมต่อกับผู้ให้บริการ Identity ภายนอกผ่านมาตรฐาน OpenID Connect (OIDC) โดยต้องสร้าง ClientConfig Custom Resource ภายใน Cluster เพื่อกำหนดความสัมพันธ์ที่เชื่อถือได้กับ Identity Provider ดังกล่าว นอกจากนี้ หากต้องการให้ผู้ใช้สามารถดึง kubeconfig และใช้งาน kubectl ผ่าน Connect Gateway ได้ ควรกำหนดสิทธิ์ IAM ด้วย Role roles/gkehub.viewer

  • การสร้างความมั่นคงปลอดภัยบน GKE อาศัยแนวทางแบบหลายชั้นที่ครอบคลุมทั้ง Cluster, Workload และข้อมูล เพื่อช่วยลดความเสี่ยงจากภัยคุกคามในทุกระดับ โดย Shielded GKE Node มีบทบาทสำคัญในการป้องกัน Rootkit และ Bootkit ที่อาจโจมตีระบบตั้งแต่ระดับการ Boot เครื่อง ขณะที่กระบวนการ CI/CD ควรมีการ Scan หาช่องโหว่ทันทีหลังจากสร้าง Container Image เพื่อค้นหา และแก้ไขปัญหาก่อนนำขึ้นใช้งานจริง นอกจากนี้ GKE Security Posture Dashboard ยังช่วยจัดลำดับความสำคัญของช่องโหว่โดยพิจารณาจากความรุนแรง ความสามารถในการถูกโจมตี และผลกระทบที่อาจเกิดขึ้น ส่วนการเพิ่มความปลอดภัยให้กับ Control Plane ควรใช้การกำหนดสิทธิ์แบบ RBAC ตามหลัก Least Privilege เพื่อให้แต่ละผู้ใช้ หรือบริการได้รับสิทธิ์เท่าที่จำเป็นเท่านั้น ผู้ดูแลระบบสามารถเข้าถึง Dashboard ดังกล่าวได้จากส่วน Kubernetes Engine ใน Google Cloud Console และยังสามารถใช้ Security Command Center เพื่อติดตาม และประเมินสถานะความปลอดภัยของทรัพยากรทั้งหมดใน Environment Google Cloud จากศูนย์กลางเดียวได้อีกด้วย

  • การทำ CI/CD บน Google Cloud สามารถใช้ Cloud Deploy เพื่อกำหนด Workflow สำหรับส่งมอบ App จากขั้นตอนพัฒนาไปจนถึง Production ผ่าน File YAML ซึ่งช่วยให้กระบวนการ Deploy มีความเป็นมาตรฐาน และทำซ้ำได้อย่างสม่ำเสมอ ด้านความปลอดภัยของระบบ CI/CD สามารถเลือกใช้ Private Pool ที่ทำงานอยู่ภายในเครือข่าย VPC ที่เชื่อมต่อกันเพื่อลดความเสี่ยงจากการเข้าถึงผ่านสาธารณะ สำหรับงานที่ต้อง Run เป็นครั้งคราวและสิ้นสุดการทำงานหลังจบภารกิจโดยไม่ต้องรอรับ HTTP Request สามารถใช้ Cloud Run Job ได้ ขณะที่ Cloud Build มีหน้าที่แปลง Source Code ให้กลายเป็น Package หรือ Container Image ที่พร้อมสำหรับการ Deploy และเมื่อเข้าสู่ Production แล้ว Binary Authorization จะช่วยบังคับใช้นโยบายด้านความปลอดภัย โดยอนุญาตให้เฉพาะ Container Image ที่ถูก Signed และมาจาก Pipeline ที่เชื่อถือได้เท่านั้นถูกนำไปใช้งานบน GKE

  • ในการนำ AI และ Machine Learning มาทำงานบน GKE ระบบจะใช้ Load Balancer เพื่อกระจายคำขอที่เข้ามายังบริการ Model Serving ให้สามารถรองรับการใช้งานจำนวนมากได้อย่างมีประสิทธิภาพ ข้อมูลที่ใช้สำหรับการฝึก Model มักถูกจัดเก็บไว้ใน Cloud Storage เพื่อให้สามารถเข้าถึง และขยายขนาดได้ง่าย โดย GKE เหมาะสำหรับงานด้าน AI โดยเฉพาะ Model ขนาดใหญ่ และการใช้งาน Hardware Accelerator เนื่องจากเป็น Platform ที่ช่วยจัดการ การปรับขนาด และการ Run Containerized Application ได้อย่างอัตโนมัติ สำหรับ GKE Autopilot ค่าใช้จ่ายจะคำนวณจากปริมาณทรัพยากรที่ Workload ใช้งานจริง เช่น CPU, Memory และ Storage ส่วนด้านความปลอดภัย Binary Authorization จะช่วยควบคุมให้เฉพาะ Container Image ที่ผ่านการรับรอง และมาจาก CI/CD Pipeline ที่เชื่อถือได้เท่านั้น สามารถนำขึ้นใช้งานใน Production บน GKE ได้

  • Google Cloud ใช้แนวคิด Shared Security Responsibility Model ซึ่งกำหนดให้ Google และลูกค้าแบ่งความรับผิดชอบด้านความปลอดภัยร่วมกัน โดย Google มีมาตรการด้านความปลอดภัยในตัว เช่น การเข้ารหัสข้อมูลขณะจัดเก็บ (Encryption at Rest) ที่ลูกค้าสามารถใช้งานเพื่อปกป้องข้อมูลได้ สำหรับบริการประเภท PaaS นั้น Google จะรับผิดชอบการดูแล Platform และความปลอดภัยของโครงสร้างพื้นฐานด้านเครือข่ายเป็นหลัก ขณะที่ลูกค้ายังคงมีหน้าที่ดูแลการ Deploy App ความปลอดภัยของ Web Application และการกำหนดสิทธิ์การเข้าถึงตามความเหมาะสม นอกจากนี้ผลิตภัณฑ์ของ Google Cloud ยังได้รับการตรวจสอบด้านความปลอดภัย ความเป็นส่วนตัว และการปฏิบัติตามข้อกำหนดจากหน่วยงานอิสระอย่างสม่ำเสมอ และการทำ Compliance ให้ครบถ้วนนั้นต้องอาศัยการควบคุมหลายด้านร่วมกัน ไม่ใช่เพียงการเปิดใช้ Encryption หรือ Firewall เท่านั้น

  • การจัดการตัวตน และสิทธิ์การเข้าถึงบน Google Cloud สามารถใช้ Cloud Identity ร่วมกับ Domain ใดก็ได้ที่สามารถรับ Email ได้ โดยไม่จำเป็นต้องใช้งาน Google Workspace เสมอไป สำหรับองค์กรที่มีระบบผู้ใช้งานอยู่แล้ว Google Cloud Directory Sync จะช่วยให้การสร้าง ปรับปรุง และยกเลิกบัญชีผู้ใช้ เป็นไปอย่างสะดวก และมีประสิทธิภาพมากขึ้น ด้าน Best Practice ในการยืนยันตัวตน และควบคุมสิทธิ์การเข้าถึง ควรหลีกเลี่ยงการกำหนดสิทธิ์รายบุคคลเมื่อสามารถใช้การจัดการผ่านกลุ่มผู้ใช้ได้ และควรจำกัดจำนวนผู้ดูแลระบบระดับ Organization ให้น้อยที่สุด โดยทั่วไปไม่ควรมีเกินสามคน เพื่อลดความเสี่ยง และทำให้การกำกับดูแลด้านความปลอดภัยมีประสิทธิภาพมากขึ้น

  • ใน Google Cloud Project เป็นหน่วยหลักสำหรับการบริหารจัดการทรัพยากร โดยสามารถใช้ติดตาม และควบคุมการใช้งาน Quota รวมถึงเลือกเปิดใช้งาน Service และ API ที่ต้องการได้ ส่วนการจัดระเบียบทรัพยากรภายใต้ Cloud IAM จะอาศัยองค์ประกอบสำคัญ ได้แก่ Organization, Folder, Member และ Role เพื่อกำหนดโครงสร้าง และสิทธิ์การเข้าถึงทรัพยากรต่าง ๆ ขณะที่ IAM Policy ทำหน้าที่เป็นชุดของกฎการอนุญาตที่ผูกกับทรัพยากร โดย Policy Binding จะเชื่อมโยงกลุ่มผู้ใช้งาน หรือ Member เข้ากับ Role ที่กำหนด ทำให้สามารถควบคุมสิทธิ์การเข้าถึงทรัพยากรได้อย่างเป็นระบบ และสอดคล้องกับแนวทางการกำกับดูแลขององค์กร

  • การรักษาความปลอดภัยเครือข่ายบน Google Cloud อาศัย Firewall Rule ที่สามารถกำหนดเงื่อนไขต่าง ๆ เช่น IP Address, Source, Direction และ Action เพื่อควบคุมการรับส่งข้อมูลได้อย่างละเอียด โดย Google Cloud Load Balancer รองรับ SSL Policy หลายระดับ และ Profile COMPATIBLE ถูกออกแบบมาเพื่อให้รองรับ Client ที่ยังใช้งานมาตรฐาน SSL รุ่นเก่าได้ สำหรับ VPC ทุกเครือข่ายจะทำงานเสมือน Distributed Firewall ที่กำหนดนโยบายในระดับ Network และ Rule Firewall ของ VPC มีขอบเขตการใช้งานแบบ Global ภายในเครือข่ายนั้น ส่วน VPC Service Control ถูกออกแบบมาเพื่อป้องกันการรั่วไหลของข้อมูล และจำกัดการเข้าถึงทรัพยากรภายใน Security Perimeter โดยข้อความที่ระบุว่า VPC Service Control ทำงานด้วยการตรวจสอบสิทธิ์จาก Cloud Identity หรือ Active Directory เพียงอย่างเดียวนั้นเป็นข้อมูลที่ไม่ถูกต้อง เนื่องจากระบบถูกออกแบบมาเพื่อควบคุมขอบเขตการเข้าถึงข้อมูล และบริการของ Google Cloud ในระดับที่กว้างกว่านั้น

  • การพัฒนา AI และ Machine Learning บน Google Cloud อาศัย TPU (Tensor Processing Unit) ซึ่งเป็น Hardware ที่ Google ออกแบบมาโดยเฉพาะเพื่อรองรับงานคำนวณด้าน Machine Learning เช่น Matrix Multiplication ที่ใช้ในการฝึก Model จำนวนมาก สำหรับการวิเคราะห์ข้อมูลที่ไม่มีการติดป้ายกำกับล่วงหน้า เช่น การจัดกลุ่มรูปภาพตามลักษณะที่คล้ายกัน จะใช้แนวทางแบบ Unsupervised Learning ร่วมกับ Cluster Analysis ขณะที่การสร้าง Model Machine Learning บน BigQuery ML สามารถเริ่มต้นได้ด้วยคำสั่ง CREATE MODEL นอกจากนี้กรอบการทำงานด้าน AI/ML ของ Google Cloud ยังแบ่งออกเป็น 3 ชั้นหลัก ได้แก่ AI Infrastructure, AI Development และ AI Applications & Solutions เพื่อรองรับตั้งแต่โครงสร้างพื้นฐานไปจนถึงการประยุกต์ใช้งานจริง และหากต้องจัดเก็บข้อมูลแบบไม่มีโครงสร้าง เช่น รูปภาพ ข้อความ หรือ File เสียง บริการที่เหมาะสมคือ Cloud Storage ซึ่งรองรับการจัดเก็บข้อมูลปริมาณมากได้อย่างยืดหยุ่น
:cool:
 
Last edited:

PlAwAnSaI

Administrator
  • การทำงานของ Generative AI สามารถใช้ Technique Few-shot Prompting เพื่อยกตัวอย่างให้ Model ดูเพียงไม่กี่ตัวอย่างก่อนให้ทำงานจริง ช่วยเพิ่มความแม่นยำในการตอบสนองตามรูปแบบที่ต้องการ โดยพื้นฐานแล้ว Generative AI เรียนรู้จากข้อมูลจำนวนมหาศาลจนเกิดเป็น Foundation Model ที่สามารถนำไปใช้งานทั่วไป หรือปรับแต่งเพิ่มเติมสำหรับงานเฉพาะทางได้ อีกทั้ง AI Agent ที่สมบูรณ์จะประกอบด้วย 3 ส่วนสำคัญ ได้แก่ Model, Tool และ Orchestration Layer ที่ช่วยประสานการทำงานร่วมกัน และหากต้องการให้ Model สร้างเนื้อหาที่มีความสร้างสรรค์ หรือคาดเดาได้ยากมากขึ้น สามารถปรับค่า Temperature ให้สูงขึ้นเพื่อเพิ่มความหลากหลายของผลลัพธ์ที่สร้างออกมา

  • ในการเลือกใช้ AI และ Machine Learning บน Google Cloud ควรเลือกเครื่องมือให้เหมาะกับทักษะ และความต้องการทางธุรกิจ หากมีข้อมูลอยู่ใน BigQuery และมีความคุ้นเคยกับ SQL การใช้ BigQuery ML จะช่วยสร้าง และใช้งาน Model Machine Learning ได้โดยไม่ต้องย้ายข้อมูลออกจากระบบ สำหรับนักวิทยาศาสตร์ข้อมูลที่ต้องการควบคุมสภาพแวดล้อม และกระบวนการพัฒนา Model อย่างเต็มรูปแบบ สามารถเลือกใช้ Custom Training ได้ ขณะที่องค์กรที่ต้องการนำ AI มาใช้งานอย่างรวดเร็วโดยไม่ต้องฝึก Model เอง เช่น การจัดหมวดหมู่ Video หรือวิเคราะห์สื่อประเภทต่าง ๆ สามารถใช้ Pre-trained APIs ได้ทันที และหากมีข้อมูลจำนวนมากต้องการสร้าง Model ของตนเองแต่ไม่มีทรัพยากร หรือความเชี่ยวชาญด้านการเขียน Code AutoML จะเป็นทางเลือกที่เหมาะสมในการพัฒนา Model Machine Learning แบบ Low-code หรือ No-code ได้อย่างมีประสิทธิภาพ

  • กระบวนการทำ Machine Learning โดยทั่วไปเริ่มจากการเตรียมข้อมูล (Data Preparation) จากนั้นเข้าสู่ขั้นตอนพัฒนา Model (Development) ซึ่งรวมถึงการฝึก และประเมินผล Model ก่อนนำไปใช้งานจริงในขั้นตอน Model Serving ในการวัดประสิทธิภาพของ Model ควรเลือก Metric ให้สอดคล้องกับเป้าหมายทางธุรกิจ เช่น กรณีการคัดแยก Apple เสียควรให้ความสำคัญกับ Precision เพื่อหลีกเลี่ยงการคัดทิ้ง Apple ดีโดยไม่จำเป็น ขณะที่การคัดกรองผู้ป่วยมะเร็งควรเน้น Recall เพื่อให้สามารถตรวจพบผู้ที่มีความเสี่ยงได้มากที่สุด นอกจากนี้ขั้นตอน Model Development ยังเป็นช่วงที่มีการ Train และ Evaluate Model และหากต้องการบริหารจัดการ Workflow ของ Machine Learning แบบอัตโนมัติ สามารถใช้ Agent Platform Pipelines เพื่อช่วย Orchestrate, Monitor และ Govern กระบวนการต่าง ๆ ได้แบบ Serverless

  • Agent Development Kit (ADK) ถูกออกแบบมาสำหรับนักพัฒนาที่ต้องการสร้างระบบแบบ Multi-Agent โดยช่วยลดความยุ่งยากด้านโครงสร้างพื้นฐาน เนื่องจากสามารถนำ Agent ไป Deploy บน Agent Engine ได้โดยไม่ต้องกังวลกับการตัดสินใจ หรือการจัดการ Infrastructure เอง นอกจากนี้ ADK ยังรองรับการใช้งานเครื่องมือได้หลากหลายรูปแบบ ทั้งเครื่องมือที่ Google เตรียมไว้ให้ เครื่องมือที่พัฒนาขึ้นเอง และเครื่องมือจากชุมชน ทำให้การพัฒนา Agent ที่มีความสามารถซับซ้อน และเชื่อมต่อกับระบบต่าง ๆ เป็นไปได้อย่างยืดหยุ่น และรวดเร็วยิ่งขึ้น

  • ใน ADK ความสามารถด้าน BiDi Streaming ช่วยให้ Agent รองรับการสื่อสารแบบโต้ตอบได้แบบ Real-time ทำให้ผู้ใช้ได้รับประสบการณ์ที่ลื่นไหล และตอบสนองทันที ขณะที่ Runner มีหน้าที่ควบคุม และจัดการลำดับการทำงานของ Agent เพื่อให้กระบวนการดำเนินไปตาม Flow ที่กำหนด นอกจากนี้ ADK ยังมี Artifact Management สำหรับจัดการ และควบคุมการเข้าถึง File หรือข้อมูลที่เกี่ยวข้องกับ Agent ได้อย่างเป็นระบบ ส่วน Session จะทำหน้าที่เก็บทั้งประวัติ และสถานะของบทสนทนาแต่ละรายการ ทำให้ Agent สามารถจดจำบริบท และดำเนินการสนทนาต่อเนื่องได้อย่างถูกต้อง

  • ในการสร้างระบบ Multi-Agent ด้วย ADK สามารถใช้ Parallel Agent เพื่อให้หลาย Agent ทำงานพร้อมกัน และช่วยเพิ่มความเร็วในการประมวลผล ขณะที่ Workflow Agent มีหน้าที่กำหนดลำดับ และการไหลของงานระหว่าง Agent ต่าง ๆ เพื่อรองรับกระบวนการทางธุรกิจที่ซับซ้อน สำหรับแนวคิดแบบลำดับชั้น (Hierarchical Approach) Agent สามารถส่งต่องานไปยัง Sub-agent, Parent Agent หรือ Peer Agent ได้ตามโครงสร้าง และความรับผิดชอบที่ถูกกำหนดไว้ นอกจากนี้ before_agent_callback ยังใช้สำหรับเตรียมทรัพยากร หรือดำเนินการที่จำเป็นก่อนเริ่มการทำงานของ Agent ส่วน Model Interaction Callback จะเป็นจุดสำหรับแทรกการทำงานรอบการโต้ตอบระหว่าง Agent กับ Large Language Model (LLM) ทำให้นักพัฒนาสามารถควบคุม และปรับแต่งพฤติกรรมของระบบได้อย่างยืดหยุ่นมากขึ้น
:cool:
 
Last edited:
Top